Les captures montrent les pages officielles à la date indiquée et peuvent différer de celles de la publication. Sélectionnez une image pour l’agrandir.
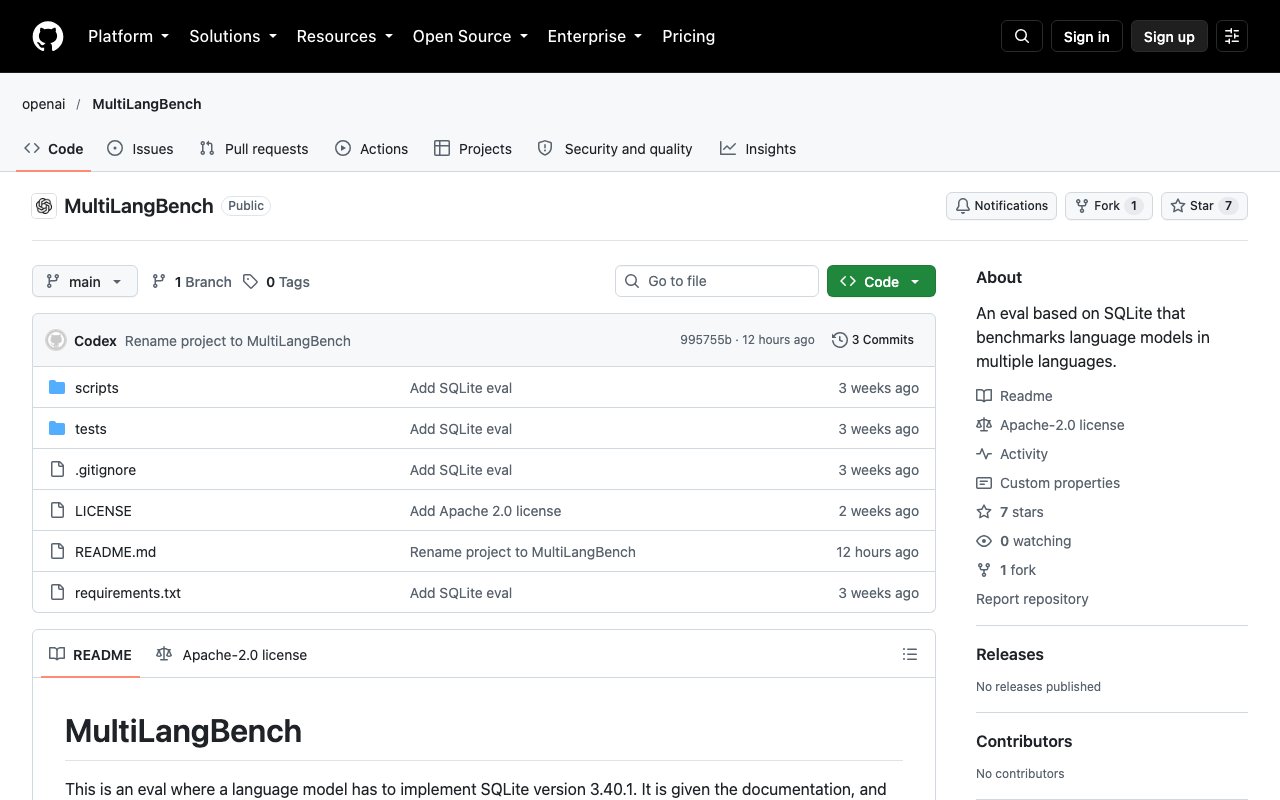
Le 19 octobre 2026 (à 21 h le même jour, heure du Japon), OpenAI a publié un article intitulé « Advancing coding in low-resource programming languages » (Faire progresser la programmation dans les langages à faibles ressources). Il explique que ses modèles d'IA les plus récents savent désormais bien mieux écrire des programmes, et les transposer dans d'autres langages, dans des langages de programmation anciens comme COBOL, Fortran et Visual Basic. En parallèle, l'entreprise a publié sur GitHub un nouveau cadre d'évaluation, MultiLangBench.
Les chiffres de cet article sont ceux qui concordent entre plusieurs articles de presse consacrés à l'annonce d'OpenAI, ainsi que la description de l'évaluation publiée sur GitHub. Tous les scores cités ont été mesurés par OpenAI elle-même.
Que sont les « langages à faibles ressources » ?
Les modèles d'IA apprennent à programmer en étudiant de grandes quantités de programmes et d'explications, dont une bonne part se trouve sur internet. Les langages très répandus comme Python et JavaScript offrent énormément d'exemples, mais pour des langages comme COBOL et Fortran, les programmes et documents publics sont bien plus rares, et l'IA y a longtemps été en difficulté. On appelle « langages à faibles ressources » ces langages pour lesquels peu de données d'entraînement existent.
COBOL sert surtout au traitement des données de gestion, et Fortran surtout au calcul scientifique et technique. Selon la presse, OpenAI indique dans son article que COBOL fait tourner plus de 40 % de la banque en ligne, 80 % des paiements par carte en magasin et 95 % des transactions aux distributeurs automatiques, et précise que Fortran est utilisé pour les prévisions météorologiques et l'analyse de sûreté des réacteurs nucléaires.
La nouvelle évaluation MultiLangBench
MultiLangBench demande aux modèles d'IA de recréer de zéro, dans 20 langages, le logiciel de base de données SQLite. SQLite est un petit moteur de base de données très répandu.
D'après la description publiée sur GitHub, le principe est le suivant.
- Le modèle ne reçoit que la documentation de SQLite 3.40.1 et doit écrire, dans le langage imposé, un programme qui se comporte de la même façon
- Il n'a pas accès à internet, et SQLite est retiré de l'environnement au préalable
- Environ 24 000 tests tirés de la suite de tests de SQLite vérifient que le programme donne les mêmes résultats que le vrai SQLite (272 d'entre eux sont utilisés par défaut)
- Écrire dans un autre langage que celui imposé, ou mélanger plusieurs langages, vaut un échec
Les 20 langages sont C, C#, C++, COBOL, Common Lisp, Fortran, Go, Java, JavaScript, Lean, OCaml, PHP, PowerShell, Python, Ruby, Rust, Scala, Swift, Visual Basic et Zig. Les tests et l'environnement sont publiés sous licence Apache 2.0.
Les scores publiés par OpenAI
Selon la presse, les principaux résultats publiés par OpenAI sont les suivants. Les chiffres correspondent à la part de tests réussis.
- GPT-6 Astra : 87,4 % en moyenne sur les 20 langages, et plus de 83 % dans 19 d'entre eux
- GPT-6 Luna : 40,3 % en moyenne, pour un coût d'environ 0,77 dollar par exécution
- GPT-5.6 Sol : 26,8 % en moyenne, pour un coût de 3,48 dollars par exécution
Langage par langage, les scores de GPT-6 Astra auraient progressé ainsi par rapport à GPT-5.6 Sol.
- COBOL : de 10,9 % à 72,1 %
- Fortran : de 21,4 % à 83,5 %
- OCaml : de 25,6 % à 85,8 %
- Visual Basic : de 27,5 % à 89,4 %
Même avec GPT-6 Astra, COBOL reste le langage où le score est le plus bas des 20.
Une évaluation du portage de programmes COBOL vers d'autres langages
OpenAI a également présenté les résultats d'une seconde évaluation, l'« évaluation de migration COBOL ». Les modèles y réécrivent des programmes COBOL en C++, Java, Kotlin, Python ou Rust, et l'on vérifie que la sortie est identique, octet par octet, à celle du programme d'origine. Elle mesure si le comportement peut être préservé lors d'une migration, c'est-à-dire le transfert d'anciens systèmes vers des langages plus récents.
Selon la presse, les résultats sont les suivants.
- GPT-6.1 Sol (réglage avec peu de raisonnement) : 86,6 %
- GPT-6.1 Sol (réglage avec beaucoup de raisonnement) : 97,9 %
- GPT-5.6 Sol (réglage avec peu de raisonnement) : 5,4 %
D'après ce que la rédaction de CoAI a pu vérifier, on ne connaît ni le nombre ni le contenu des programmes utilisés pour cette évaluation, et on ne sait pas si son cadre sera publié.
Disponibilité et points de vigilance
D'après la presse, ces améliorations concernent ChatGPT ainsi que les modèles les plus récents accessibles via l'API. Il ne s'agit pas du lancement d'un nouveau produit, mais d'une annonce montrant que les modèles existants sont devenus plus performants. À notre connaissance, aucune indication particulière n'a été donnée sur Codex ni sur des informations en japonais.
OpenAI prévient que les migrations de systèmes réels exigent toujours une vérification par des experts ainsi que des tests adaptés aux règles métier de chaque système et à ses liens avec d'autres systèmes.
Le lien avec les anciens systèmes du Japon
Au Japon aussi, la gestion des anciens systèmes centraux (ceux qui font tourner les activités clés d'une entreprise) est un défi de longue date. Dans son rapport DX de 2018, le ministère de l'Économie, du Commerce et de l'Industrie (METI) a tiré la sonnette d'alarme sur le « précipice de 2025 », le risque que les anciens systèmes freinent la DX (la transformation par le numérique). Dans le rapport de synthèse de son comité pour la modernisation des systèmes hérités, établi en mai 2025, le METI relève que 61 % des entreprises ayant répondu à son enquête possèdent encore d'anciens systèmes (systèmes hérités), et que les effectifs informatiques ne cessent de diminuer à mesure que les ingénieurs expérimentés s'en vont.
Beaucoup d'anciens systèmes tournant sur des mainframes (grands ordinateurs de gestion) sont écrits en COBOL. Si l'IA parvient à lire et écrire correctement ces langages, elle pourrait aider à comprendre de vieux programmes dont les spécifications ont disparu, et à les porter vers des langages plus récents.
Le regard de CoAI
Jusqu'ici, l'évaluation de l'IA en programmation portait surtout sur des langages très répandus comme Python et JavaScript. Cette annonce d'OpenAI est importante parce qu'elle s'intéresse à COBOL et Fortran, qui tournent encore dans les banques, les administrations et ailleurs, et parce qu'elle rend public le cadre d'évaluation. Des tests accessibles à tous permettent de comparer plus facilement, dans les mêmes conditions, les modèles d'autres entreprises.
En revanche, les chiffres ont été mesurés par OpenAI elle-même, et nous n'avons pas pu vérifier le contenu de l'évaluation de migration COBOL. Dans les systèmes qui manipulent de l'argent ou des données personnelles, la moindre différence de comportement peut avoir de lourdes conséquences. Même en confiant une migration à l'IA, mieux vaut partir du principe, comme le dit OpenAI elle-même, qu'une vérification par des experts et des tests suffisants sont indispensables.
Sources
- Advancing coding in low-resource programming languages (OpenAI)
- openai/MultiLangBench (GitHub)
- DXの現在地とレガシーシステム脱却に向けて レガシーシステムモダン化委員会総括レポート (METI japonais, publié par l'IPA)
- OpenAI's COBOL Test: 5.4% to 86.6% in One Model Jump (CellCog)
- OpenAI releases coding benchmark and reports sharp gains in COBOL (Superpower Daily)