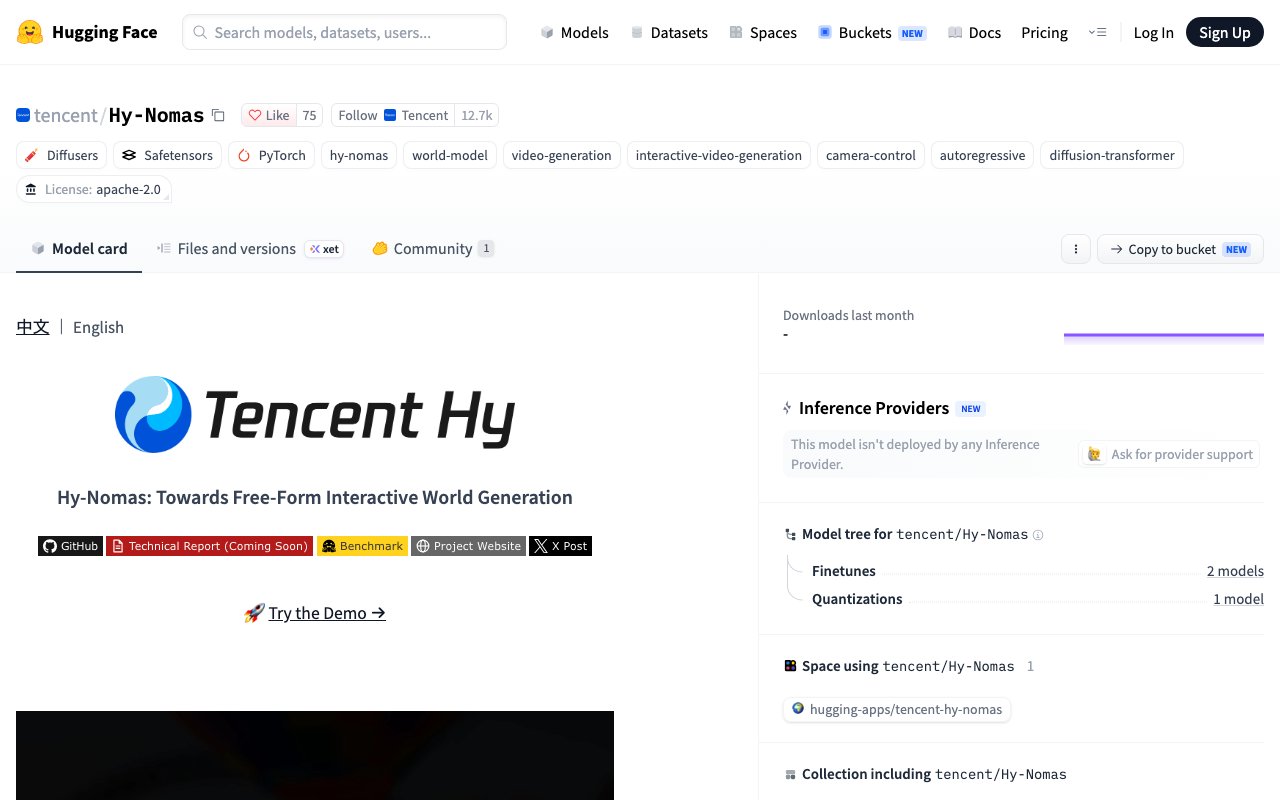
Les captures montrent les pages officielles à la date indiquée et peuvent différer de celles de la publication. Sélectionnez une image pour l’agrandir.
Le 24 octobre 2026 (heure de Chine et du Japon), l'équipe Hunyuan de Tencent a annoncé sur son compte X officiel Hy-Nomas, un modèle d'IA qui construit en continu un « monde » vidéo. En combinant des instructions textuelles et des mouvements de caméra, il génère la scène segment par segment et permet, en cours de route, d'ajouter des objets ou de modifier le style visuel et les mouvements. Les poids du modèle et le code sont disponibles sur Hugging Face et GitHub, sous la licence Apache-2.0, propice à l'usage commercial.
Qu'est-ce que Hy-Nomas
Hy-Nomas est une IA que Tencent qualifie de « modèle interactif de génération de mondes vidéo ». Une IA de génération vidéo classique produit une vidéo de durée fixe à partir d'une seule instruction. Hy-Nomas, lui, crée la vidéo par courts segments et accepte une nouvelle instruction à chaque fois.
Selon la fiche du modèle, il est possible pendant la génération de :
- Ajouter des objets, changer le style visuel ou la scène, ou indiquer des mouvements aux éléments présents, par le texte
- Spécifier des mouvements de caméra pour se déplacer dans le monde
- Alterner instructions textuelles et commandes de caméra
Le modèle dispose d'un mécanisme qui mémorise le contenu des segments précédents (une mémoire du monde), ce qui permet selon Tencent de conserver la cohérence de l'apparence et de la disposition au fil de la scène.
Performances et configuration
La version rapide publiée produit une vidéo de 720 pixels de haut sur 1280 de large, à 24 images par seconde, en 8 étapes de traitement. D'après la description sur GitHub, elle prend en charge des réglages à 4, 6 et 8 étapes.
La configuration standard suppose huit GPU. Mais en combinant la quantification INT8, qui allège le modèle, et le transfert d'une partie des traitements vers le CPU, Tencent propose une configuration capable de fonctionner sur une seule carte grand public de NVIDIA, la GeForce RTX 4090. Attention : cette configuration à une seule carte concerne la partie qui génère la vidéo ; le mécanisme d'enrichissement des instructions utilisé dans la démo web exige des ressources de calcul séparées.
Les 24 images par seconde correspondent à la cadence de lecture de la vidéo, et rien n'indique si la génération suit le temps réel. La fiche du modèle ne mentionne pas non plus le nombre de paramètres ni la durée maximale des vidéos. Le média spécialisé étranger VP Land a rapporté « 8 milliards de paramètres, jusqu'à 60 secondes » en citant la page du projet, mais CoAI n'a pas pu le vérifier dans des sources primaires.
Ce qui a été publié en même temps
Outre le modèle lui-même, les éléments suivants ont été publiés :
- Un LoRA (petit module d'entraînement complémentaire) pour un rendu cinématographique
- Un LoRA pour la robotique (entraîné sur des données d'un vrai robot à deux bras)
- Le code d'entraînement, d'inférence et de démo, ainsi qu'un outil pour légender les données d'entraînement
- Le jeu de données d'évaluation Hy-Nomas-Bench (280 entrées)
Tencent explique que le LoRA pour la robotique vise à améliorer la capacité à reproduire les mouvements d'un robot dans le monde généré, ce qui laisse penser que l'entreprise vise non seulement la production vidéo, mais aussi la simulation robotique. Une démo en ligne, utilisable dans le navigateur, est également proposée.
Licence et évaluation
La licence est Apache-2.0 et s'applique non seulement au code mais aussi aux poids du modèle. Les composants tiers inclus (comme le modèle Qwen utilisé pour lire le texte) restent toutefois soumis à leurs licences d'origine. Le fichier LICENSE précise qu'aucune restriction supplémentaire n'est ajoutée. Certains modèles Hunyuan précédents avaient été publiés sous des licences maison qui excluaient certaines régions ou plafonnaient le nombre d'utilisateurs. Le choix d'une formule aussi ouverte retient donc l'attention.
En revanche, aucun chiffre de performance n'a été publié. Hy-Nomas-Bench teste quatre aspects : plusieurs tours d'instructions textuelles, le mouvement de caméra, la combinaison instructions-caméra et la mémoire des lieux, mais ni scores ni comparaisons avec d'autres modèles n'ont été rendus publics. Le rapport technique est toujours annoncé « prochainement ».
La course aux modèles de monde
Un modèle de monde est une IA qui crée, à partir de texte ou d'autres entrées, un monde virtuel dans lequel on peut se déplacer. Au-delà de la production de jeux et de vidéos, ces modèles suscitent l'intérêt pour entraîner dans des environnements virtuels l'IA des robots et des voitures autonomes.
Tencent avait déjà publié sa série de modèles de monde HY-World ; HY-World 2.0, en avril, générait des données 3D modifiables. Hy-Nomas ne produit pas de données 3D : il étend le monde en enchaînant progressivement des vidéos, et se distingue par la possibilité d'insérer des instructions textuelles autant de fois que voulu. Aucune comparaison de performances avec HY-World n'a été présentée.
Le regard de CoAI
Hy-Nomas tente de faire passer l'IA de génération vidéo du « on crée une fois et c'est fini » au « on ajoute des instructions au fil de la création ». Comme les poids et le code sont publiés sous Apache-2.0 et qu'il existe une configuration fonctionnant sur une seule carte grand public, chercheurs et développeurs peuvent facilement l'essayer sur leurs propres machines.
Cependant, ni chiffres de performance ni rapport technique ne sont encore disponibles, si bien que sa qualité ne peut être jugée qu'à travers les démos et les explications de Tencent. Pour l'essayer, mieux vaut d'abord vérifier son comportement dans la démo en ligne ou avec des réglages légers, et attendre le rapport technique et des évaluations externes avant de l'utiliser sérieusement.