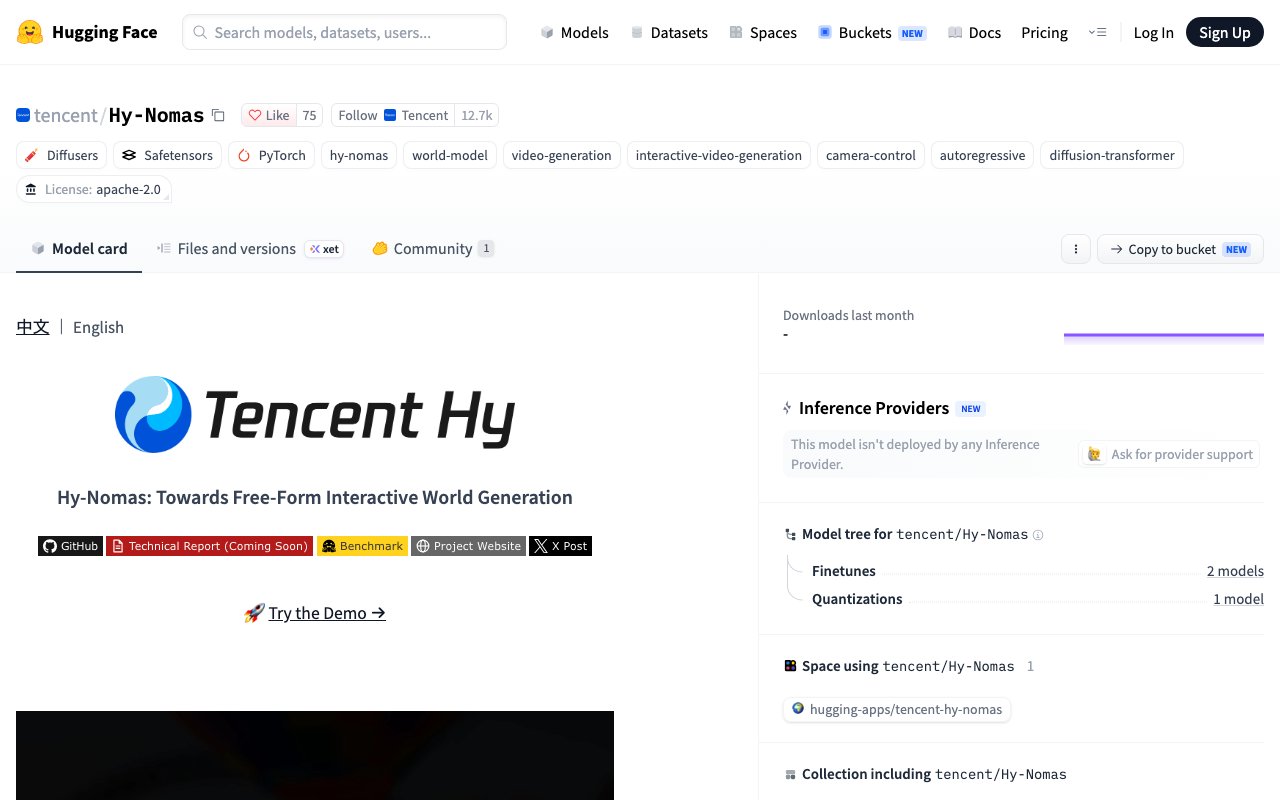
촬영일 기준 공식 페이지이며 기사 게시 당시와 다를 수 있습니다. 이미지를 선택하면 확대할 수 있습니다.
Tencent(텐센트)의 훈위안(Hunyuan) 팀은 2026년 10월 24일(중국 시간·일본 시간), 영상 속 '세계'를 계속 만들어 가는 AI 모델 'Hy-Nomas'를 공식 X 계정에서 공개했습니다. 텍스트 지시와 카메라 움직임을 조합해 장면을 구간마다 생성하며, 도중에 사물을 추가하거나 화풍과 움직임을 바꿀 수 있습니다. 모델 가중치와 코드는 Hugging Face와 GitHub에 공개되어 있으며, 라이선스는 상업적으로도 쓰기 쉬운 Apache-2.0입니다.
Hy-Nomas란
Hy-Nomas는 Tencent가 '대화형 영상 세계 생성 모델'이라고 부르는 AI입니다. 일반적인 영상 생성 AI는 하나의 지시로 정해진 길이의 영상을 만듭니다. Hy-Nomas는 영상을 짧은 구간(세그먼트)마다 만들고, 그때마다 새로운 지시를 받습니다.
모델 카드에 따르면 생성 도중에 다음과 같은 조작이 가능합니다.
- 텍스트로 사물을 추가하거나, 화풍이나 장면을 바꾸거나, 등장하는 대상에 움직임을 지시한다
- 카메라 움직임을 지정해 세계 안을 이동한다
- 텍스트 지시와 카메라 조작을 번갈아 넣는다
앞 구간의 내용을 기억해 두는 장치(세계의 기억)를 갖추고 있어, 장면이 이어져도 겉모습과 배치의 일관성을 유지한다고 합니다.
성능과 구동 환경
공개된 고속 버전 모델은 8단계 처리로 세로 720×가로 1280픽셀, 초당 24프레임의 영상을 출력합니다. GitHub 설명에 따르면 4·6·8단계 설정을 지원합니다.
표준 구성은 GPU 8장 사용을 전제로 합니다. 한편 모델을 가볍게 만드는 양자화(INT8)와 일부 처리를 CPU에 맡기는 설정을 조합하면, NVIDIA의 소비자용 GPU 'GeForce RTX 4090' 한 장으로도 돌릴 수 있는 구성을 마련했습니다. 다만 이 한 장 구성은 영상을 만드는 부분에 관한 것이며, 웹 데모에서 쓰는 지시문 보강 장치에는 별도의 계산 자원이 필요합니다.
참고로 24프레임은 재생되는 영상의 프레임 수이며, 생성 속도가 실시간을 따라잡는지는 밝혀지지 않았습니다. 파라미터 수와 최대 영상 길이도 모델 카드에는 적혀 있지 않습니다. 해외 전문 매체 VP Land는 프로젝트 페이지의 기재 내용으로 '80억 파라미터, 최대 60초'라고 전했지만, CoAI는 1차 정보에서 확인하지 못했습니다.
함께 공개된 것
모델 본체 외에 다음 항목도 공개되었습니다.
- 영화 같은 화면 연출을 위한 LoRA(추가 학습용 소형 부품)
- 로봇용 LoRA(실제 양팔 로봇 데이터로 학습)
- 학습·추론·데모 코드와 학습 데이터에 설명을 붙이는 장치
- 평가용 데이터 'Hy-Nomas-Bench'(280건)
Tencent는 로봇용 LoRA에 대해 만들어 낸 세계에서 로봇의 움직임을 재현하는 능력을 높이기 위한 것이라고 설명하고 있어, 영상 제작뿐 아니라 로봇 시뮬레이션 용도도 염두에 두고 있음을 엿볼 수 있습니다. 브라우저에서 사용해 볼 수 있는 온라인 데모도 마련되어 있습니다.
라이선스와 평가
라이선스는 Apache-2.0으로, 코드뿐 아니라 모델 가중치에도 적용됩니다. 다만 함께 포함된 다른 회사의 부품(텍스트를 읽어 들이는 부분에 쓰이는 Qwen 모델 등)은 각각 원래 라이선스를 따릅니다. LICENSE에는 그 이상의 제한은 추가하지 않는다고 적혀 있습니다. 지금까지 훈위안 모델 중 일부는 특정 지역을 제외하거나 사용자 수에 상한을 두는 독자 라이선스로 공개되어 왔습니다. 이번에 자유도가 높은 형태로 공개했다는 점이 눈에 띕니다.
한편 성능 수치는 나오지 않았습니다. 평가용 Hy-Nomas-Bench는 여러 차례의 텍스트 지시, 카메라 이동, 지시와 카메라의 조합, 장소 기억의 네 가지를 시험하는 내용이지만, 점수나 다른 모델과의 비교는 공개되지 않았습니다. 기술 보고서도 '곧 공개' 상태입니다.
세계 모델 경쟁
세계 모델은 텍스트 등으로부터 돌아다닐 수 있는 가상 세계를 만드는 AI입니다. 게임과 영상 제작은 물론, 로봇이나 자율주행 AI를 가상 환경에서 훈련하는 용도로도 주목받고 있습니다.
Tencent는 그동안 세계 모델 HY-World 시리즈도 공개해 왔으며, 4월에 나온 HY-World 2.0은 편집 가능한 3D 데이터를 만드는 모델이었습니다. Hy-Nomas는 3D 데이터를 만드는 대신 영상을 조금씩 이어 붙여 세계를 넓혀 가는 방식이며, 텍스트 지시를 몇 번이든 끼워 넣을 수 있다는 점이 특징입니다. HY-World와의 성능 비교는 제시되지 않았습니다.
CoAI 편집부의 시각
Hy-Nomas는 영상 생성 AI를 '한 번 만들고 끝'에서 '만들면서 지시를 거듭해 가는' 것으로 넓히려는 시도입니다. 가중치와 코드가 Apache-2.0으로 공개되었고 소비자용 GPU 한 장으로도 돌아가는 구성이 있어, 연구자와 개발자가 손쉽게 직접 시험해 볼 수 있다는 것이 장점입니다.
다만 성능 수치도 기술 보고서도 아직 나오지 않아, 좋고 나쁨은 Tencent의 데모와 설명으로만 판단할 수 있습니다. 시험해 본다면 먼저 온라인 데모나 가벼운 설정으로 동작을 확인하고, 본격적인 활용은 기술 보고서나 외부 평가가 나온 뒤로 미루는 것이 좋겠습니다.