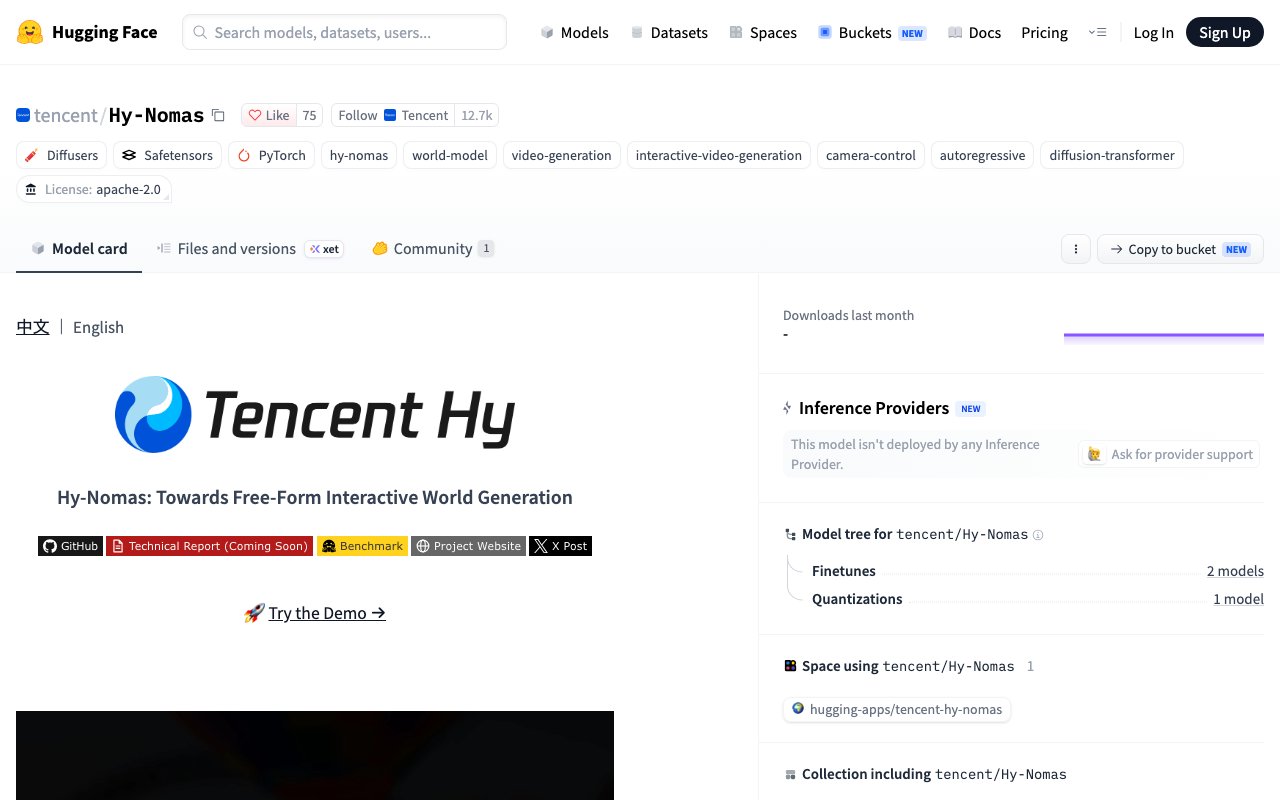
As capturas mostram as páginas oficiais na data indicada e podem diferir das páginas na publicação. Selecione uma imagem para ampliá-la.
Em 24 de outubro de 2026 (horário da China e do Japão), a equipe Hunyuan da Tencent anunciou em sua conta oficial no X o "Hy-Nomas", um modelo de IA que continua criando um "mundo" em vídeo. Ele combina instruções em texto e movimentos de câmera para gerar cenas segmento por segmento, e permite, no meio do processo, adicionar objetos ou mudar o estilo visual e os movimentos. Os pesos do modelo e o código estão disponíveis no Hugging Face e no GitHub, sob a licença Apache-2.0, que facilita inclusive o uso comercial.
O que é o Hy-Nomas
O Hy-Nomas é uma IA que a Tencent chama de "modelo interativo de geração de mundos em vídeo". Os geradores de vídeo comuns criam um vídeo de duração fixa a partir de uma única instrução. Já o Hy-Nomas cria o vídeo em trechos curtos (segmentos) e aceita uma nova instrução a cada trecho.
Segundo o model card, é possível fazer as seguintes operações durante a geração:
- Com texto, adicionar objetos, mudar o estilo visual ou a cena e dar instruções de movimento aos elementos que aparecem
- Definir movimentos de câmera para se deslocar dentro do mundo
- Alternar entre instruções em texto e comandos de câmera
O modelo tem um mecanismo que guarda o conteúdo dos segmentos anteriores (memória do mundo) e, segundo a Tencent, mantém a consistência da aparência e da disposição dos elementos à medida que as cenas continuam.
Desempenho e requisitos
A versão rápida publicada gera, em 8 etapas de processamento, vídeos de 720 pixels de altura por 1280 de largura, a 24 quadros por segundo. Segundo a descrição no GitHub, há suporte a configurações de 4, 6 e 8 etapas.
A configuração padrão pressupõe o uso de 8 GPUs. Por outro lado, combinando quantização (INT8), que deixa o modelo mais leve, com o envio de parte do processamento para a CPU, há uma configuração que roda até em uma única GPU doméstica da NVIDIA, a "GeForce RTX 4090". No entanto, essa configuração com uma placa se refere apenas à parte que cria o vídeo; o mecanismo que reforça os prompts usado na demo web exige recursos computacionais à parte.
Vale notar que os 24 quadros são a taxa de reprodução do vídeo, e não foi informado se a velocidade de geração acompanha o tempo real. O número de parâmetros e a duração máxima dos vídeos também não constam no model card. O site especializado VP Land informou "8 bilhões de parâmetros e até 60 segundos" com base na página do projeto, mas o CoAI não conseguiu confirmar esses dados em fontes primárias.
O que foi publicado junto
Além do modelo principal, também foram publicados:
- Um LoRA (um pequeno componente para treinamento adicional) voltado a imagens com cara de cinema
- Um LoRA para robótica (treinado com dados de um robô real de dois braços)
- Código de treinamento, inferência e demonstração, além de um sistema para adicionar descrições aos dados de treino
- O conjunto de dados de avaliação "Hy-Nomas-Bench" (280 itens)
A Tencent explica que o LoRA para robótica serve para melhorar a capacidade de reproduzir movimentos de robôs nos mundos criados, o que sugere que o modelo foi pensado não só para produção audiovisual, mas também para simulação robótica. Há ainda uma demo online que pode ser testada no navegador.
Licença e avaliação
A licença é a Apache-2.0 e vale não só para o código, mas também para os pesos do modelo. Porém, componentes de terceiros incluídos no pacote (como o modelo Qwen usado na parte que lê o texto) seguem suas próprias licenças originais. O arquivo LICENSE afirma que não são impostas restrições adicionais. Alguns modelos Hunyuan anteriores foram publicados com licenças próprias que excluíam certas regiões ou limitavam o número de usuários. Desta vez, chama a atenção a publicação em um formato muito mais livre.
Por outro lado, não há números de desempenho. O Hy-Nomas-Bench testa quatro aspectos: múltiplas instruções em texto, movimentos de câmera, combinação de instruções e câmera, e memória de lugares, mas nem as pontuações nem comparações com outros modelos foram divulgadas. O relatório técnico também segue como "em breve".
A disputa dos modelos de mundo
Modelos de mundo são IAs que criam, a partir de texto e outras entradas, mundos virtuais nos quais é possível se mover. Eles chamam atenção não só para games e produção audiovisual, mas também para treinar IAs de robôs e de direção autônoma em ambientes virtuais.
A Tencent já havia lançado a série de modelos de mundo HY-World, e o HY-World 2.0, de abril, era um modelo que gerava dados 3D editáveis. O Hy-Nomas não cria dados 3D: ele expande o mundo ligando pouco a pouco trechos de vídeo, e se destaca por permitir inserir instruções em texto quantas vezes for preciso. Não foi apresentada nenhuma comparação de desempenho com o HY-World.
A visão do CoAI
O Hy-Nomas é uma tentativa de levar a geração de vídeo por IA de algo "feito uma vez e pronto" para algo em que se vai acrescentando instruções enquanto o vídeo é criado. Como os pesos e o código estão sob Apache-2.0 e há uma configuração que roda em uma única GPU doméstica, pesquisadores e desenvolvedores podem testá-lo facilmente em suas próprias máquinas.
Ainda assim, não há números de desempenho nem relatório técnico, e a qualidade só pode ser avaliada pelas demos e explicações da própria Tencent. Para quem quiser experimentar, o melhor é começar pela demo online ou por configurações mais leves para verificar o funcionamento, e deixar o uso sério para depois da publicação do relatório técnico e de avaliações externas.