Fireworks AI
Fireworks AI
Inferência, treinamento e implantações dedicadas para modelos abertos, cobrados por tokens e horas de GPU.
Plataformas
Visão geral
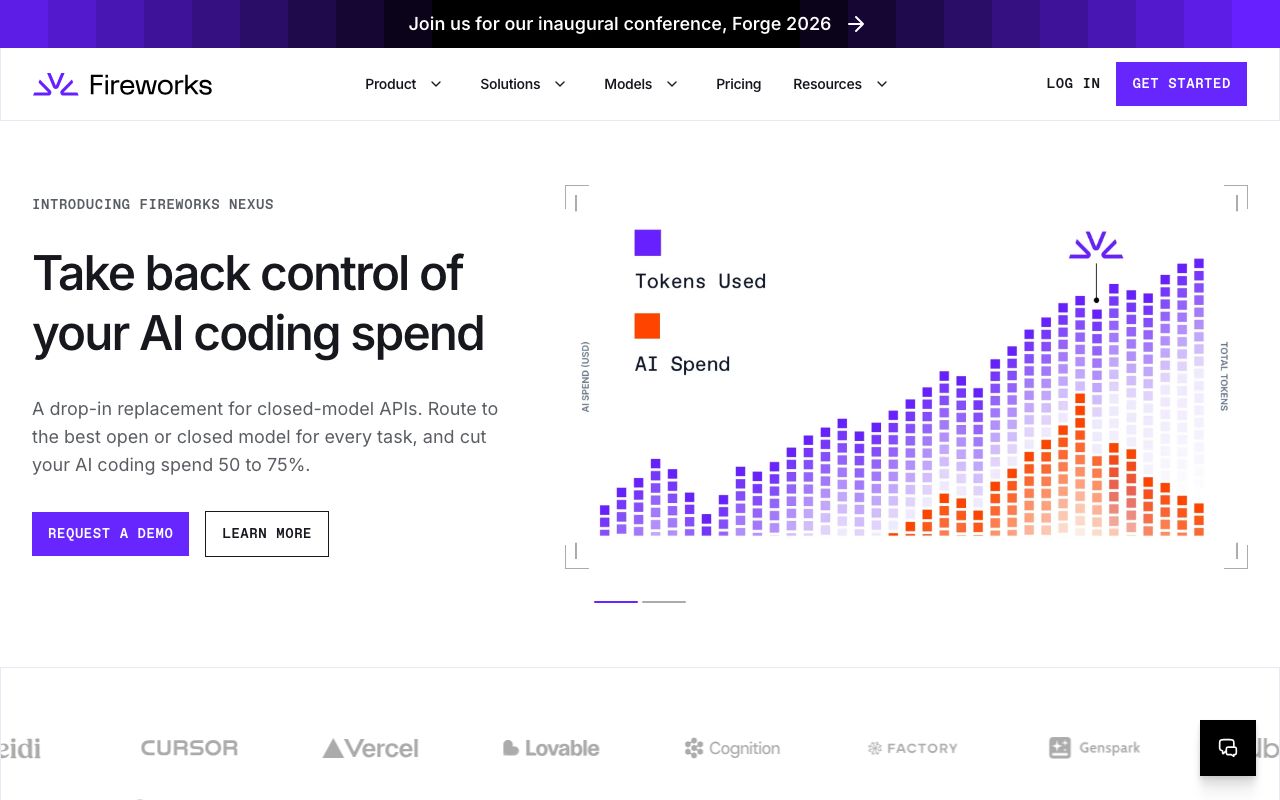
A Fireworks AI é uma plataforma de inferência para modelos abertos. Sua página de preços, intitulada preços para escalar sem atrito da ideia à empresa, divide-se em três: inferência serverless por token, treinamento por token de treinamento e implantações dedicadas sob demanda por hora de GPU. No treinamento, para modelos de até 16B, o LoRA SFT custa 0,50 dólar por milhão de tokens e o SFT de parâmetros completos, 1,00. Sob demanda, H100/H200 custa 8 dólares a hora e B200, 13. No início são oferecidos 1 dólar em créditos gratuitos.
Principais recursos
- Inferência serverless cobrada por token
- Ajuste fino (LoRA e parâmetros completos)
- GPUs dedicadas sob demanda
- 1 dólar em créditos gratuitos no início
- Condições sob medida para empresas
Preços
Training (up to 16B, LoRA SFT)
US$ 0,50 / 1M training tokens
Preço publicado (USD) · Fonte
- Up to 16B: LoRA SFT $0.50 / Full Param SFT $1.00
- 16.1B-80B: LoRA SFT $3.00 / Full Param SFT $6.00
- 80B-300B: $6.00-$24.00
- >300B: $10.00-$40.00
- All per 1M training tokens
Última verificação: setembro de 2026
On-demand deployments
US$ 8 / GPU hour
Preço publicado (USD) · Fonte
- H100/H200: $8.00/hour
- B200: $13.00/hour
- B300/GB300: $15.00-$20.00/hour
Última verificação: setembro de 2026
Serverless inference (embeddings example)
US$ 0,10 / 1M input tokens
Preço publicado (USD) · Fonte
- Qwen3 8B embeddings: $0.1 per 1M input tokens
- Embeddings up to 150M params: $0.008
- Embeddings 150M-350M params: $0.016
- Get started with $1 in free credits
Última verificação: setembro de 2026
Enterprise
Falar com vendas
- Faster speeds and lower costs
- Higher rate limits
- Contact us for a quote
O Fireworks AI publica um preço único mundial e cobra em USD. Não há um preço separado na sua moeda local.
Capturas de tela
Ferramentas de IA relacionadas
Together AI
Together AI é um serviço de IA de infraestrutura de desenvolvimento/API que pode ser usado para desenvolvimento de IA e inferência.
Replicate
Replicate é um serviço de IA de infraestrutura de desenvolvimento/API que pode ser usado para desenvolvimento de IA e prototipagem.
Groq
Nuvem de inferência construída sobre o próprio processador LPU, com capacidade dedicada em larga escala.
OpenRouter
OpenRouter é um serviço de IA de infraestrutura de desenvolvimento/API que pode ser usado para desenvolvimento de IA e comparação de modelos.