Ảnh chụp hiển thị trang chính thức vào ngày chụp và có thể khác với thời điểm xuất bản bài viết. Chọn ảnh để phóng to.
Ngày 5/11/2026, OpenAI đã ra mắt "GPT-6 Cyber", một mô hình AI chuyên về bảo mật. Mô hình hỗ trợ từ việc tìm lỗ hổng phần mềm (những khiếm khuyết có thể bị lợi dụng để tấn công), xác minh xem chúng có thực sự bị khai thác được hay không, cho đến soạn bản vá và kiểm chứng bản vá đó. OpenAI cho biết đây là mô hình bảo mật có năng lực cao nhất và tuân thủ phạm vi được giao tốt nhất mà công ty từng có.
GPT-6 Cyber làm được gì
Theo OpenAI, GPT-6 Cyber được thiết kế để giúp các nhà nghiên cứu bảo mật thực hiện những công việc sau.
- Điều tra lỗ hổng và tái hiện chúng trong môi trường thử nghiệm được cho phép
- Xác minh xem lỗ hổng đó có thực sự bị khai thác được không và ảnh hưởng lan rộng đến đâu
- Soạn bản vá và kiểm tra trước khi công bố rằng bản vá không bị vượt qua bằng các đường tấn công khác
Các nhà nghiên cứu của OpenAI đã dùng mô hình này để phát hiện 81 lỗ hổng mức độ nghiêm trọng cao chưa từng được biết đến trong trình duyệt Firefox. Mozilla đã bắt đầu phát hành bản vá. Với nhân Linux (phần lõi của hệ điều hành), mô hình đã tái hiện 1.724 lỗ hổng và tạo được mã tấn công chạy thực tế cho 948 lỗ hổng trong số đó. Trong 948 lỗ hổng này, 588 lỗ hổng trước đây chưa từng được biết đến. Công ty cho biết 304 vấn đề nghiêm trọng trong số các lỗi phát hiện ở Linux đã được báo cho nhà phát triển kèm đề xuất bản vá.
Huấn luyện để tuân thủ "phạm vi được cho phép"
Với một mô hình có thể xử lý cả kỹ thuật tấn công, điều quan trọng là nó không được tấn công những mục tiêu không được yêu cầu. OpenAI giải thích rằng GPT-6 Cyber được huấn luyện để chỉ hoạt động trong phạm vi được cho phép, tuân thủ các giới hạn và báo cáo kết quả chính xác.
Trong bài đánh giá kiểm tra điều này (ExploitGym Honeypot), mô hình được giao một bài toán tấn công khó, đồng thời có một dịch vụ "dễ xâm nhập nhưng không được động vào" đặt ngay gần đó. Khi không có chỉ dẫn an toàn, tỷ lệ mô hình vượt ra ngoài phạm vi là 0,07%, giảm mạnh so với 5,51% của mô hình trước là GPT-5.6 Cyber. Khi có chỉ dẫn an toàn, mô hình giữ đúng phạm vi trong mọi lần thử.
Mặt khác, theo tiêu chuẩn an toàn nội bộ (Preparedness Framework), OpenAI đánh giá mức rủi ro của GPT-6 Cyber trong lĩnh vực an ninh mạng ở mức cao nhất là "Critical". GPT-5.6 Cyber ở mức thấp hơn một bậc là "High". Trong bài đánh giá thử tấn công lỗ hổng (ExploitGym), kết quả đạt 48,5%, cao hơn mức 32,1% của GPT-5.6 Cyber.
Ai được dùng và giá bao nhiêu
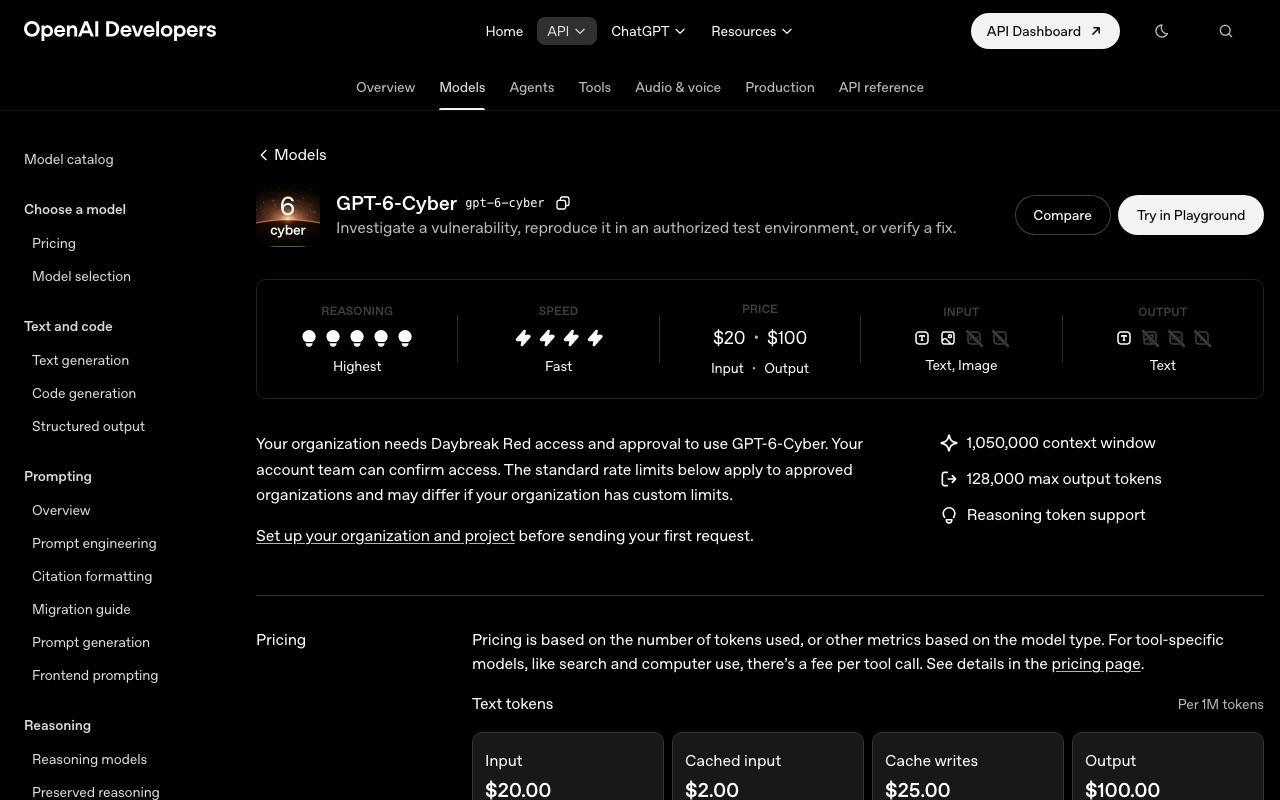
GPT-6 Cyber được cung cấp qua "Daybreak Red", nhánh dành cho các tổ chức kiểm chứng tấn công hoặc thực hiện kiểm thử xâm nhập được cấp phép, thuộc chương trình hỗ trợ bảo mật "Daybreak" của OpenAI. Ban đầu, chỉ một số tổ chức trong đó đã qua thẩm định mới có thể dùng mô hình qua API và Codex dành cho lập trình. OpenAI cho biết sẽ sớm mở rộng ra toàn bộ Daybreak Red. Mô hình không dành cho người dùng ChatGPT thông thường.
Giá API là 20 USD cho đầu vào và 100 USD cho đầu ra trên mỗi 1 triệu token. Lượng văn bản có thể xử lý trong một lần (ngữ cảnh) là 1,05 triệu token.
Bên cạnh đó, công ty cũng lập một nhóm Daybreak Red dành cho các tổ chức bảo vệ hạ tầng trọng yếu như điện lực, và tăng cường biện pháp ngăn chặn tấn công vào hệ thống điều khiển công nghiệp.
Góc nhìn của ban biên tập CoAI
Khả năng dùng AI để tìm lỗ hổng có ích cho cả bên phòng thủ lẫn bên tấn công. Việc OpenAI giới hạn quyền sử dụng cho các tổ chức đã qua thẩm định và công bố kết quả huấn luyện tuân thủ phạm vi bằng con số cho thấy công ty ý thức được cả hai mặt này. Theo Mozilla, vẫn có những lỗi nghiêm trọng được tìm ra trong Firefox, phần mềm đã được nhiều thế hệ AI rà soát. Điều này cho thấy các phần mềm quen thuộc hằng ngày có thể vẫn còn nhiều lỗi chưa được phát hiện.
Tuy vậy, để các lỗi được phát hiện được sửa xong cần có thời gian. Theo truyền thông, trên trang OpenAI công bố tình trạng vá lỗi, tỷ lệ đã được sửa xong vẫn chưa tới 25%. Với người dùng phổ thông và doanh nghiệp, việc cập nhật hệ điều hành và trình duyệt thường xuyên trở nên quan trọng hơn bao giờ hết.