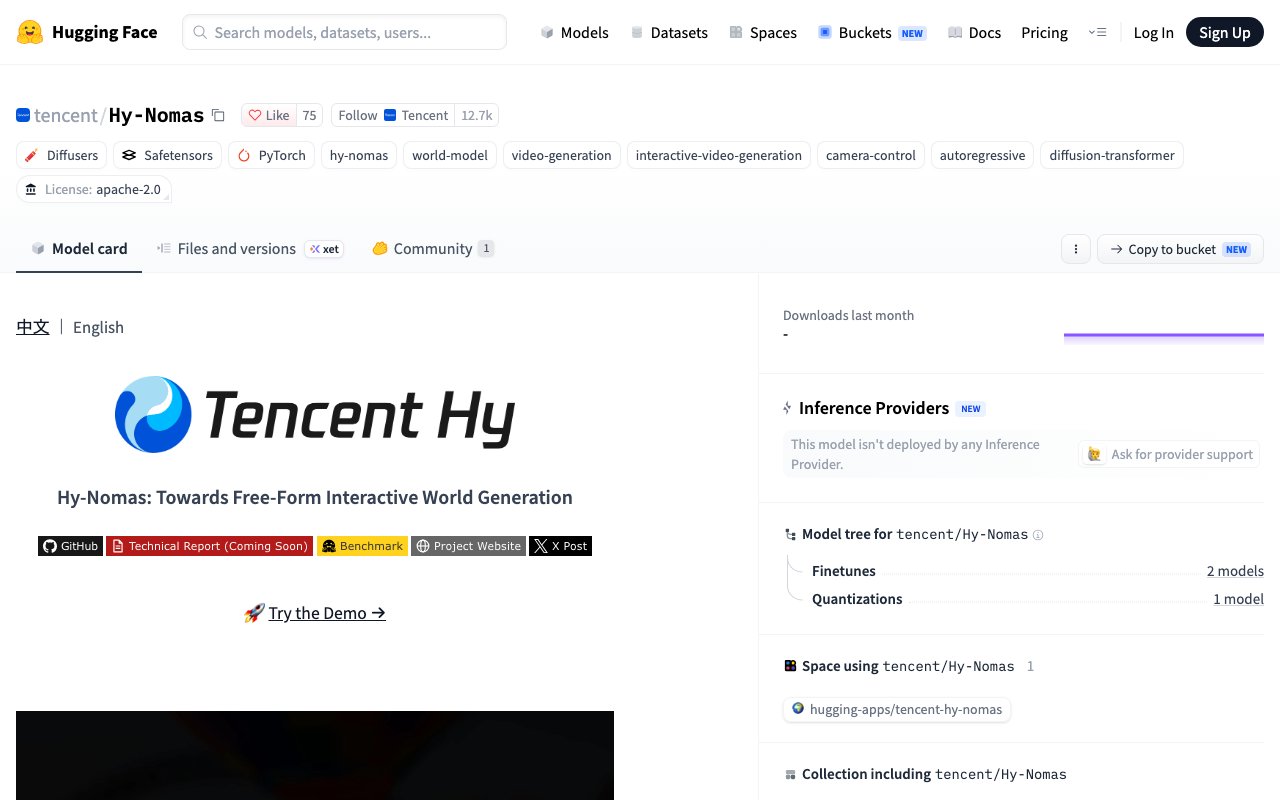
Ảnh chụp hiển thị trang chính thức vào ngày chụp và có thể khác với thời điểm xuất bản bài viết. Chọn ảnh để phóng to.
Ngày 24/10/2026 (giờ Trung Quốc và Nhật Bản), nhóm Hunyuan của Tencent công bố trên tài khoản X chính thức "Hy-Nomas", một mô hình AI liên tục tạo ra "thế giới" dưới dạng video. Mô hình kết hợp chỉ dẫn văn bản với chuyển động máy quay để tạo cảnh theo từng phân đoạn, và cho phép thêm vật thể hoặc thay đổi phong cách hình ảnh, chuyển động ngay giữa chừng. Trọng số mô hình và mã nguồn được công bố trên Hugging Face và GitHub, với giấy phép Apache-2.0 dễ sử dụng kể cả cho mục đích thương mại.
Hy-Nomas là gì
Hy-Nomas là AI mà Tencent gọi là "mô hình tạo thế giới video tương tác". Các AI tạo video thông thường tạo ra một video có độ dài cố định từ một chỉ dẫn duy nhất. Còn Hy-Nomas tạo video theo từng đoạn ngắn (phân đoạn) và nhận chỉ dẫn mới ở mỗi đoạn.
Theo model card, có thể thực hiện các thao tác sau trong quá trình tạo:
- Dùng văn bản để thêm vật thể, thay đổi phong cách hình ảnh hoặc bối cảnh, và chỉ dẫn chuyển động cho các đối tượng xuất hiện
- Chỉ định chuyển động máy quay để di chuyển trong thế giới
- Xen kẽ chỉ dẫn văn bản và điều khiển máy quay
Mô hình có cơ chế ghi nhớ nội dung của các phân đoạn trước (bộ nhớ thế giới), và theo Tencent, có thể giữ được sự nhất quán về hình ảnh và bố cục khi cảnh tiếp tục kéo dài.
Hiệu năng và yêu cầu phần cứng
Phiên bản tốc độ cao được công bố tạo video cao 720 × rộng 1280 điểm ảnh, 24 khung hình mỗi giây, qua 8 bước xử lý. Theo mô tả trên GitHub, mô hình hỗ trợ các thiết lập 4, 6 và 8 bước.
Cấu hình tiêu chuẩn giả định sử dụng 8 GPU. Mặt khác, khi kết hợp lượng tử hóa (INT8) giúp mô hình nhẹ hơn với thiết lập chuyển một phần xử lý sang CPU, sẽ có cấu hình chạy được ngay cả trên một GPU dành cho người dùng phổ thông của NVIDIA là "GeForce RTX 4090". Tuy nhiên, cấu hình một card này chỉ áp dụng cho phần tạo video; cơ chế bổ sung câu lệnh dùng trong bản demo web cần thêm tài nguyên tính toán riêng.
Cũng cần lưu ý rằng 24 khung hình là số khung hình khi phát video, và chưa có thông tin cho biết tốc độ tạo có theo kịp thời gian thực hay không. Số lượng tham số và độ dài video tối đa cũng không được ghi trong model card. Trang tin chuyên ngành nước ngoài VP Land đưa tin "8 tỷ tham số, tối đa 60 giây" dựa trên nội dung trang dự án, nhưng CoAI chưa thể xác nhận thông tin này từ nguồn chính thức.
Những gì được công bố kèm theo
Ngoài mô hình chính, các nội dung sau cũng được công bố:
- LoRA (thành phần nhỏ dùng để huấn luyện bổ sung) cho hình ảnh mang phong cách điện ảnh
- LoRA cho robot (huấn luyện bằng dữ liệu từ một robot hai tay thực tế)
- Mã huấn luyện, suy luận và demo, cùng cơ chế gắn mô tả cho dữ liệu huấn luyện
- Bộ dữ liệu đánh giá "Hy-Nomas-Bench" (280 mục)
Tencent giải thích rằng LoRA cho robot nhằm nâng cao khả năng tái hiện chuyển động của robot trong thế giới được tạo ra, cho thấy mô hình không chỉ hướng tới sản xuất video mà còn cả mô phỏng robot. Ngoài ra còn có bản demo trực tuyến có thể dùng thử trên trình duyệt.
Giấy phép và đánh giá
Giấy phép là Apache-2.0, áp dụng không chỉ cho mã nguồn mà cả trọng số mô hình. Tuy nhiên, các thành phần của bên khác đi kèm (như mô hình Qwen dùng ở phần đọc hiểu văn bản) vẫn tuân theo giấy phép gốc của từng bên. File LICENSE ghi rằng không áp đặt thêm hạn chế nào khác. Trước đây, một số mô hình Hunyuan được công bố với giấy phép riêng, loại trừ một số khu vực hoặc giới hạn số người dùng. Lần này, việc công bố dưới hình thức tự do hơn nhiều là điểm đáng chú ý.
Mặt khác, chưa có con số hiệu năng nào. Hy-Nomas-Bench kiểm tra bốn nội dung: nhiều lần chỉ dẫn văn bản, di chuyển máy quay, kết hợp chỉ dẫn và máy quay, và ghi nhớ địa điểm, nhưng điểm số cũng như so sánh với các mô hình khác chưa được công bố. Báo cáo kỹ thuật vẫn ở trạng thái "sắp ra mắt".
Cuộc cạnh tranh mô hình thế giới
Mô hình thế giới là AI tạo ra thế giới ảo có thể di chuyển bên trong từ văn bản và các đầu vào khác. Ngoài sản xuất game và video, chúng còn được chú ý cho mục đích huấn luyện AI của robot và xe tự lái trong môi trường ảo.
Tencent trước đây đã công bố dòng mô hình thế giới HY-World, trong đó HY-World 2.0 ra mắt hồi tháng 4 là mô hình tạo dữ liệu 3D có thể chỉnh sửa. Hy-Nomas không tạo dữ liệu 3D mà mở rộng thế giới bằng cách nối dần các đoạn video, và nổi bật ở chỗ có thể chèn chỉ dẫn văn bản bao nhiêu lần tùy ý. Chưa có so sánh hiệu năng nào với HY-World.
Góc nhìn của ban biên tập CoAI
Hy-Nomas là nỗ lực mở rộng AI tạo video từ kiểu "tạo một lần là xong" sang kiểu "vừa tạo vừa thêm chỉ dẫn". Vì trọng số và mã nguồn được công bố theo Apache-2.0, lại có cấu hình chạy được trên một GPU phổ thông, các nhà nghiên cứu và nhà phát triển có thể dễ dàng thử nghiệm trên máy của mình.
Tuy nhiên, chưa có con số hiệu năng lẫn báo cáo kỹ thuật, nên chất lượng chỉ có thể đánh giá qua demo và lời giải thích của Tencent. Nếu muốn thử, trước hết nên kiểm tra hoạt động qua bản demo trực tuyến hoặc với thiết lập nhẹ, và chỉ nên sử dụng nghiêm túc sau khi có báo cáo kỹ thuật và đánh giá từ bên ngoài.