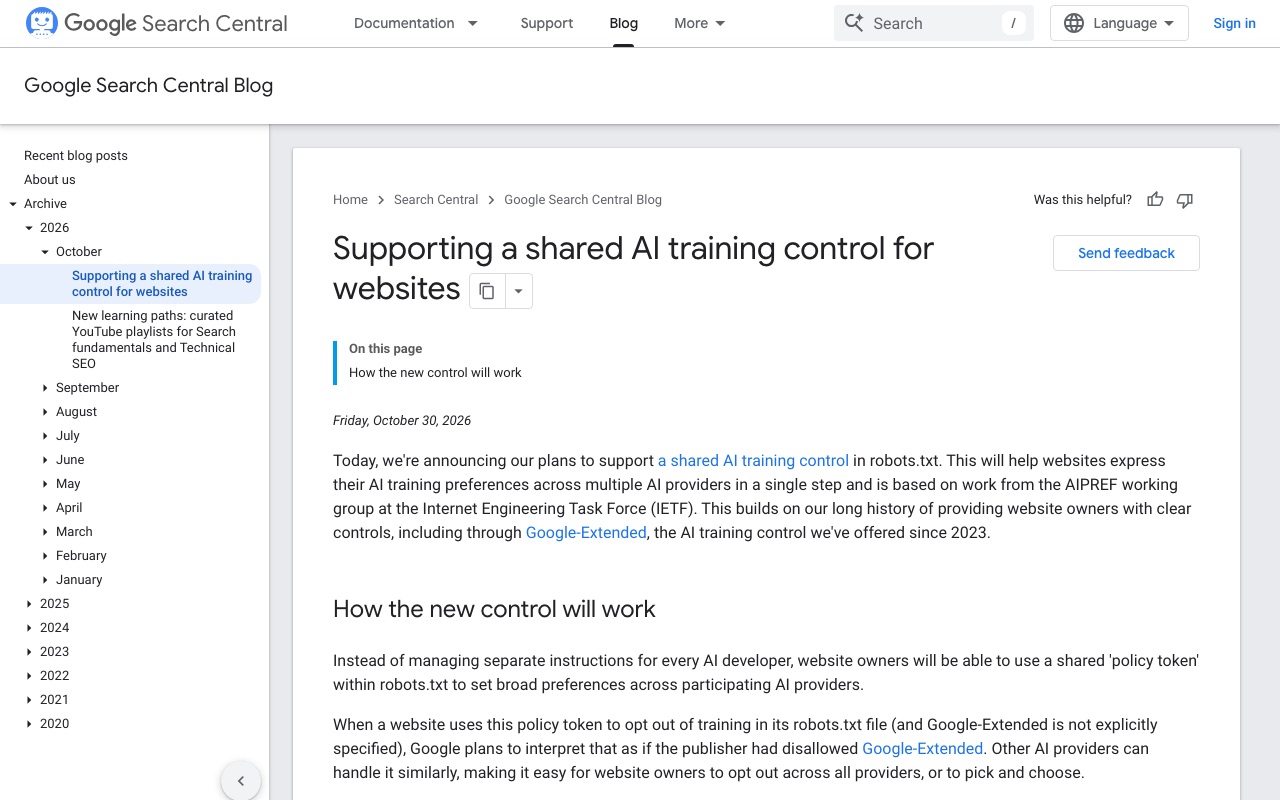
Les captures montrent les pages officielles à la date indiquée et peuvent différer de celles de la publication. Sélectionnez une image pour l’agrandir.
Le 30 octobre 2026 (heure des États-Unis), OpenAI, Google, Microsoft et Anthropic ont annoncé qu'ils prendraient en charge un mécanisme permettant aux exploitants de sites web d'indiquer, au moyen d'une syntaxe commune dans robots.txt, s'ils souhaitent ou non que le contenu de leur site serve à entraîner l'IA générative. Jusqu'ici, pour refuser l'entraînement de l'IA, il fallait écrire un par un les noms propres à chaque entreprise, comme GPTBot ou Google-Extended ; désormais, une seule entrée suffira pour signifier son choix à toutes les entreprises qui la prennent en charge.
Le principe : écrire « __usage_ai-training » dans robots.txt
Le mécanisme repose sur le document « Machine-Readable Training Preference Signal », que Kevin Kelley, d'Anthropic, a soumis le même jour à l'IETF (l'organisme où sont discutées les normes techniques d'internet). Sur la ligne « User-Agent » de robots.txt, où l'on écrit normalement le nom d'un robot d'exploration, on place le jeton commun « __usage_ai-training », puis on indique en dessous, chemin par chemin, avec Disallow (refuser) et Allow (autoriser), si le contenu peut servir à l'entraînement.
Voici l'exemple donné dans le document.
- User-Agent: __usage_ai-training
- Disallow: /
- Allow: /press-kit/
Dans ce cas, le site indique qu'il ne souhaite pas que l'ensemble de son contenu serve à l'entraînement, à l'exception de ce qui se trouve sous /press-kit/, qui peut y servir.
Le document précise également les points suivants.
- « User-Agent: * » (l'indication destinée à tous les robots d'exploration) ne s'applique pas à ce jeton. Pour refuser l'entraînement, il faut écrire ce jeton explicitement
- L'entraînement désigne ici l'utilisation du contenu pour modifier les paramètres d'un modèle d'IA générative. Les modèles servant uniquement à la classification ou au classement ne sont pas concernés
- Aucune nouvelle directive ni nouvelle syntaxe n'est ajoutée ; la syntaxe existante de robots.txt est utilisée telle quelle
- La signification des entrées visant le nom du robot d'une entreprise, comme GPTBot, ne change pas
À noter que ce document n'est pas une norme officielle de l'IETF : il s'agit pour l'instant d'une proposition soumise à titre individuel.
Ce que prévoit chaque entreprise
Les quatre entreprises ont annoncé qu'elles prendraient en charge le jeton commun, tout en précisant que leurs réglages propres resteront utilisables. Le calendrier et les modalités diffèrent toutefois d'une entreprise à l'autre.
- Anthropic : l'entreprise à l'origine du document aurait déjà commencé à le prendre en charge
- OpenAI : le prendra en charge dans les prochains mois. Elle précise qu'il ne remplace pas les réglages existants
- Microsoft (Bing) : tiendra compte de cette indication lors de l'exploration à partir du 1er février 2027
- Google : vise une prise en charge en 2027
L'explication de Google comporte un point à surveiller. Si un site refuse l'entraînement avec le jeton commun sans rien indiquer au sujet de Google-Extended, Google prévoit de considérer que Google-Extended est lui aussi refusé. Or Google-Extended concerne non seulement l'entraînement des modèles Gemini, mais aussi l'utilisation du contenu comme source des réponses dans l'application Gemini. Google indique que les sites qui autorisent explicitement Google-Extended continueront d'apparaître comme sources des réponses dans l'application Gemini et pourront recevoir des clics.
Bing ajoute aussi un réglage pour refuser l'usage comme « source des réponses »
Le même jour, Microsoft a également annoncé un réglage, distinct de celui sur l'entraînement, permettant de choisir si une page peut servir de source (grounding) aux réponses de l'IA dans Bing, Copilot et d'autres services.
- Entraînement : en plus du jeton commun de robots.txt, l'indication peut aussi se faire page par page avec une balise meta (par exemple <meta name="Bingbot" content="ai-training:disallow">) ou un en-tête HTTP. L'indication par page prime sur celle de robots.txt
- Source des réponses : page par page, on peut choisir « disallow », qui refuse tout, ou « disallowextended », qui refuse uniquement l'usage en dehors des produits de Microsoft elle-même
Microsoft affirme que ces réglages ne changent rien au fait qu'une page puisse ou non figurer dans les résultats de recherche classiques de Bing. En revanche, elle explique que refuser l'usage comme source des réponses rend la page moins susceptible d'apparaître dans les réponses générées par l'IA. Par ailleurs, à partir du 1er mars 2027, elle ne lira plus à cette fin « NoArchive » et « NoCache », qu'elle traitait jusqu'ici comme des indications relatives à l'IA. Pour la transition, à partir du 15 décembre 2026, seuls les sites qui utilisent NoArchive ou NoCache à cette date pourront définir dans Bing Webmaster Tools des préférences temporaires concernant l'usage comme source des réponses.
Le regard de CoAI
Jusqu'à présent, les sites qui voulaient refuser l'entraînement de l'IA devaient ajouter un nom dans robots.txt chaque fois qu'un nouveau robot d'exploration apparaissait. Le fait que les quatre grandes entreprises adoptent la même syntaxe réduit fortement cette charge. La généralisation de réglages permettant de distinguer l'entraînement de l'IA générative et l'usage comme source des réponses de l'IA est aussi un progrès pour les exploitants de sites.
Tout ne changera pas du jour au lendemain, cependant. Google et Microsoft ne commenceront qu'en 2027, et OpenAI s'est contentée d'évoquer « les prochains mois », sans donner de date précise. Ce mécanisme sert en outre uniquement à exprimer une préférence : il n'a aucun pouvoir contraignant sur les entreprises qui ne le prennent pas en charge. Côté Google, attention : même si l'on pense ne refuser que l'entraînement, le contenu ne sera plus utilisé dans les réponses de l'application Gemini si Google-Extended n'est pas autorisé. Pour le moment, le plus prudent est de conserver aussi les entrées existantes propres à chaque entreprise.
Sources
- Machine-Readable Training Preference Signal (IETF Datatracker)
- Making it easier for websites to express AI training preferences (OpenAI)
- Supporting a shared AI training control for websites (Google Search Central Blog)
- Your content, your choice: clearer preferences for training and grounding (Microsoft Bing Blogs)
- Google, OpenAI, Microsoft, and Anthropic back a shared robots.txt AI training signal (Coywolf)
Outils mentionnés dans cet article
 ChatGPTL’IA conversationnelle d’OpenAI pour répondre aux questions, rédiger, résumer, programmer et trouver des idées.Voir les détails
 GeminiL'IA conversationnelle de Google, capable de s'intégrer à la recherche Google et à Workspace.Voir les détails
 ClaudeUn assistant IA conversationnel d'Anthropic, réputé pour sa compréhension des textes longs et la génération de texte naturel.Voir les détails
 Microsoft CopilotMicrosoft Copilot est un assistant IA généraliste, utile pour répondre aux questions et effectuer des recherches.Voir les détails