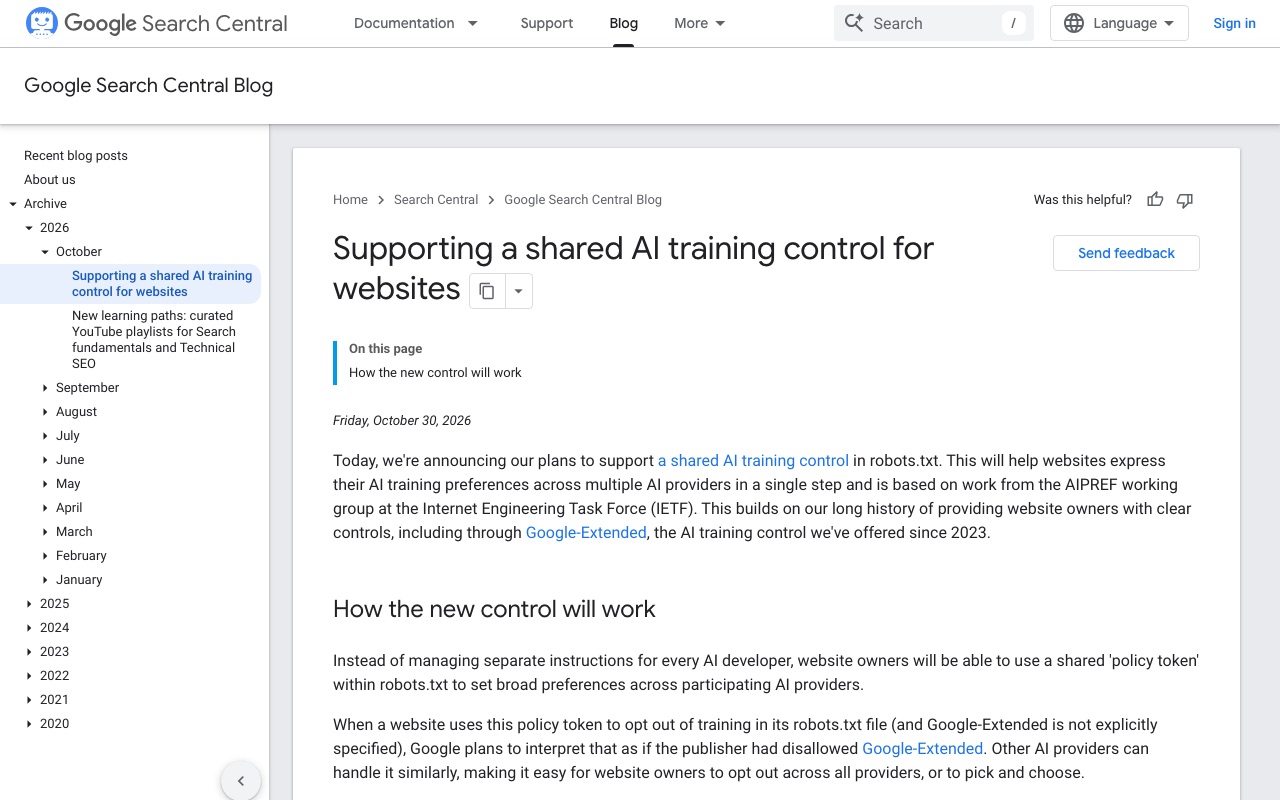
Le schermate mostrano le pagine ufficiali alla data indicata e possono differire da quelle alla pubblicazione. Seleziona un’immagine per ingrandirla.
Il 30 ottobre 2026 (ora degli Stati Uniti) OpenAI, Google, Microsoft e Anthropic hanno annunciato che supporteranno un meccanismo che consente ai gestori di siti web di indicare, con una sintassi comune in robots.txt, se vogliono o meno che i contenuti del proprio sito vengano usati per addestrare l'IA generativa. Finora, per rifiutare l'addestramento dell'IA bisognava scrivere uno per uno i nomi specifici di ciascuna azienda, come GPTBot o Google-Extended; d'ora in poi basterà una sola voce per comunicare la propria scelta a tutte le aziende che la supportano.
Come funziona: scrivere "__usage_ai-training" in robots.txt
Alla base c'è il documento "Machine-Readable Training Preference Signal", presentato lo stesso giorno da Kevin Kelley di Anthropic all'IETF (l'organismo in cui si discutono gli standard tecnici di internet). Nella riga "User-Agent" di robots.txt, dove di solito si scrive il nome di un crawler, si inserisce il token comune "__usage_ai-training" e, sotto, si indica percorso per percorso con Disallow (rifiuta) e Allow (consenti) se i contenuti possono essere usati per l'addestramento.
L'esempio riportato nel documento è il seguente.
- User-Agent: __usage_ai-training
- Disallow: /
- Allow: /press-kit/
In questo caso il sito esprime la volontà che nessuno dei suoi contenuti venga usato per l'addestramento, tranne quelli sotto /press-kit/, che invece possono esserlo.
Il documento stabilisce anche i seguenti punti.
- "User-Agent: *" (l'indicazione rivolta a tutti i crawler) non si applica a questo token. Per rifiutare l'addestramento bisogna scrivere esplicitamente questo token
- Per addestramento si intende qui l'uso dei contenuti per modificare i parametri di un modello di IA generativa. I modelli usati solo per classificare od ordinare sono esclusi
- Non vengono aggiunte nuove direttive né nuova sintassi; si usa la sintassi di robots.txt già esistente
- Il significato delle voci che indicano il nome del crawler di un'azienda, come GPTBot, non cambia
Va precisato che questo documento non è uno standard ufficiale dell'IETF, ma per ora una proposta presentata a titolo individuale.
Cosa faranno le singole aziende
Tutte e quattro le aziende hanno annunciato che supporteranno il token comune, precisando che le impostazioni specifiche di ciascuna resteranno utilizzabili. Tempi e modalità, però, cambiano da azienda ad azienda.
- Anthropic: è l'azienda che ha presentato il documento e, secondo quanto riportato, ha già iniziato a supportarlo
- OpenAI: lo supporterà nei prossimi mesi. Afferma che non sostituisce le impostazioni attuali
- Microsoft (Bing): dal 1° febbraio 2027 terrà conto di questa indicazione durante la scansione
- Google: punta a supportarlo nel 2027
La spiegazione di Google contiene un punto a cui fare attenzione. Se un sito rifiuta l'addestramento con il token comune e non scrive nulla su Google-Extended, Google prevede di considerare rifiutato anche Google-Extended. Google-Extended riguarda non solo l'addestramento dei modelli Gemini, ma anche l'uso dei contenuti come fonte delle risposte nell'app Gemini. Google afferma che i siti che consentono esplicitamente Google-Extended continueranno a comparire come fonti delle risposte nell'app Gemini e a poter ricevere clic.
Bing aggiunge anche un'impostazione per rifiutare l'uso come "fonte delle risposte"
Lo stesso giorno Microsoft ha annunciato anche un'impostazione, separata da quella sull'addestramento, che permette di scegliere se una pagina può essere usata come fonte (grounding) delle risposte dell'IA in Bing, Copilot e altri servizi.
- Addestramento: oltre al token comune di robots.txt, si può indicare pagina per pagina anche con un meta tag (ad esempio <meta name="Bingbot" content="ai-training:disallow">) o con un'intestazione HTTP. Le indicazioni a livello di pagina hanno la precedenza su quelle di robots.txt
- Fonte delle risposte: pagina per pagina si può scegliere tra "disallow", che rifiuta tutto, e "disallowextended", che rifiuta solo l'uso al di fuori dei prodotti di Microsoft stessa
Microsoft afferma che queste impostazioni non cambiano la possibilità che una pagina compaia nei normali risultati di ricerca di Bing. D'altra parte, spiega che rifiutare l'uso come fonte delle risposte rende meno probabile che la pagina compaia nelle risposte generate dall'IA. Inoltre, dal 1° marzo 2027 smetterà di leggere a questo scopo "NoArchive" e "NoCache", che finora trattava come indicazioni relative all'IA. Per la transizione, dal 15 dicembre 2026, solo i siti che in quel momento usano NoArchive o NoCache potranno configurare in Bing Webmaster Tools preferenze temporanee sull'uso come fonte delle risposte.
Il punto di vista di CoAI
Finora i siti che volevano rifiutare l'addestramento dell'IA dovevano aggiungere un nome in robots.txt ogni volta che compariva un nuovo crawler. Il fatto che le quattro grandi aziende adottino la stessa sintassi riduce molto questo lavoro. Anche la diffusione di impostazioni che permettono di trattare separatamente l'addestramento dell'IA generativa e l'uso come fonte delle risposte dell'IA è un passo avanti per i gestori dei siti.
Non cambierà però tutto subito. Google e Microsoft partiranno nel 2027, e OpenAI si è limitata a dire "nei prossimi mesi", senza indicare una data precisa. Inoltre questo meccanismo serve solo a comunicare una preferenza: non ha alcun potere di imporla alle aziende che non lo supportano. Per Google, attenzione: anche se si intende rifiutare solo l'addestramento, se non si consente Google-Extended i contenuti non verranno più usati nelle risposte dell'app Gemini. Per il momento la scelta più sicura è mantenere anche le voci esistenti specifiche di ciascuna azienda.
Fonti
- Machine-Readable Training Preference Signal (IETF Datatracker)
- Making it easier for websites to express AI training preferences (OpenAI)
- Supporting a shared AI training control for websites (Google Search Central Blog)
- Your content, your choice: clearer preferences for training and grounding (Microsoft Bing Blogs)
- Google, OpenAI, Microsoft, and Anthropic back a shared robots.txt AI training signal (Coywolf)
Strumenti citati in questo articolo
 ChatGPTL’IA conversazionale di OpenAI per rispondere a domande, scrivere, riassumere, programmare e sviluppare idee.Vedi dettagli
 GeminiL'IA conversazionale di Google, integrabile con la Ricerca Google e Workspace.Vedi dettagli
 ClaudeL'assistente IA conversazionale di Anthropic, eccellente nella comprensione di testi lunghi e nella generazione di testo naturale.Vedi dettagli
 Microsoft CopilotMicrosoft Copilot è un assistente AI generico utile per rispondere a domande e per la ricerca.Vedi dettagli