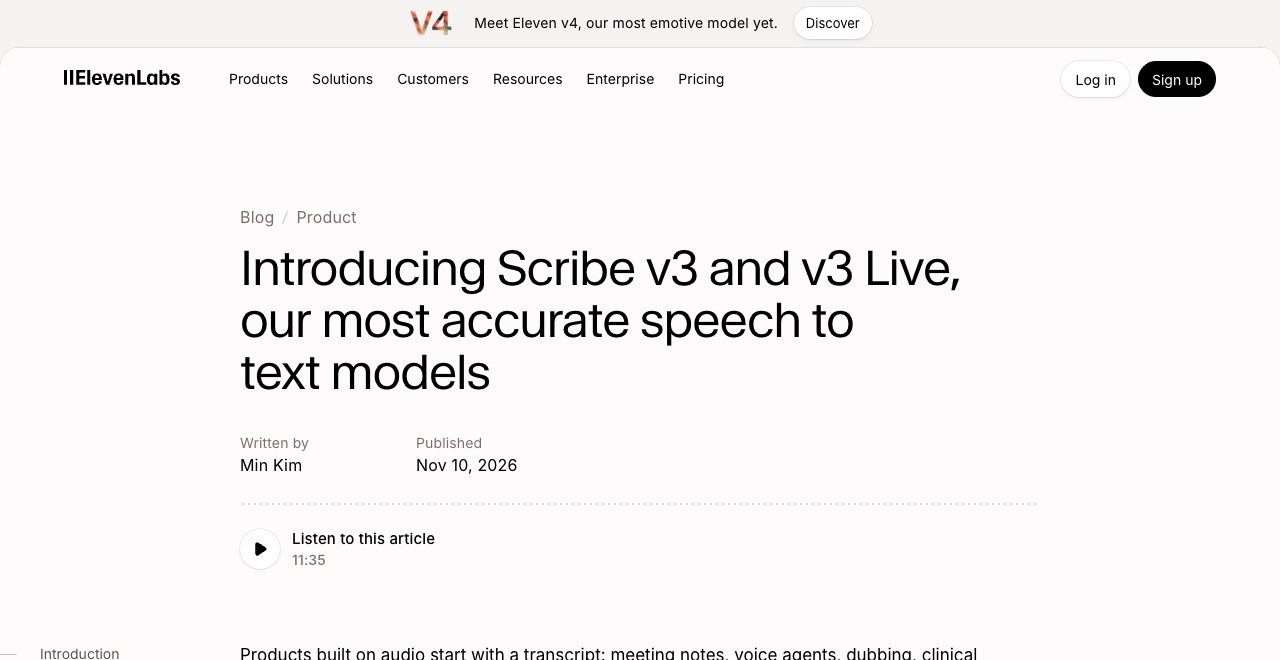
Le schermate mostrano le pagine ufficiali alla data indicata e possono differire da quelle alla pubblicazione. Seleziona un’immagine per ingrandirla.
Il 10 novembre 2026 ElevenLabs, azienda di IA vocale, ha lanciato Scribe v3, un'IA che trasforma la voce in testo. Le versioni sono due: Scribe v3, per l'audio registrato, e Scribe v3 Live, per trascrivere sul momento conversazioni e altri contenuti in tempo reale.
Precisione molto migliorata
Secondo ElevenLabs, Scribe v3 commette il 27% di errori di parola in meno rispetto al precedente Scribe v2. Il confronto è stato fatto su 102 lingue, e l'azienda afferma che la precisione è migliorata in tutte le lingue provate. Per lingua, gli errori sono calati del 42% in tedesco, del 35% in spagnolo, del 23% in inglese e del 28% in thailandese. È migliorata anche la precisione nel distinguere chi parla nelle registrazioni con più persone, e nelle conversazioni con 3 o più persone gli errori sono calati del 17%, secondo l'azienda.
Scribe v3 Live, la versione in tempo reale, commette il 43% in meno di errori che cambiano il senso di quanto detto rispetto alla precedente versione in tempo reale. Per la prima volta riesce anche a distinguere chi parla in tempo reale. Nella parte in inglese dei dati di valutazione propri di ElevenLabs, il tasso di errore nel distinguere chi parla è del 3,1%, inferiore a quello degli altri modelli in tempo reale provati da ElevenLabs (dal 5,9% al 7,3%), secondo l'azienda.
Funzioni principali
Ecco le funzioni principali. Le prime 3 sono funzioni di Scribe v3, la versione per l'audio registrato.
- Si possono registrare fino a 1.000 termini tecnici e nomi propri, così da trascriverli correttamente con più facilità (la versione in tempo reale ha un sistema che permette di registrarne di più)
- Si può scegliere se scrivere i numeri in cifre o in lettere
- Si può indicare con un linguaggio normale come impaginare la trascrizione, per esempio "sistemalo in questo formato"
- La versione in tempo reale gestisce anche le conversazioni in cui si cambia lingua a metà frase
- Capisce se chi parla ha finito non solo dai silenzi, ma anche dall'andamento della conversazione
I confronti di precisione sono misurazioni della stessa ElevenLabs.
Dove si può usare
Scribe v3 e Scribe v3 Live sono diventati i modelli predefiniti nelle app di ElevenLabs. Gli sviluppatori possono passare al nuovo modello semplicemente cambiando il modello indicato nell'API. Scribe v3 Live si può usare anche nel servizio di ElevenLabs per creare agenti di IA conversazionali.
Per le aziende sono disponibili opzioni come la mancata conservazione dei dati, l'elaborazione in ambienti isolati nell'UE, in India o a Singapore oltre che negli Stati Uniti, l'opzione standard, e contratti conformi alle norme statunitensi sui dati sanitari (HIPAA). L'annuncio non indica i prezzi, che vanno verificati nella pagina dei prezzi di ElevenLabs.
Il punto di vista di CoAI
ElevenLabs è nota per la lettura vocale dei testi, ma ora punta anche sull'alta precisione nella trascrizione. Secondo l'azienda la precisione è migliorata in 102 lingue, quindi ci si possono aspettare progressi anche nella trascrizione di registrazioni di riunioni e interviste, comprese quelle in giapponese. L'annuncio, però, non indica di quanto sia migliorato il giapponese, perciò la cosa più sicura è provarlo con audio reali.