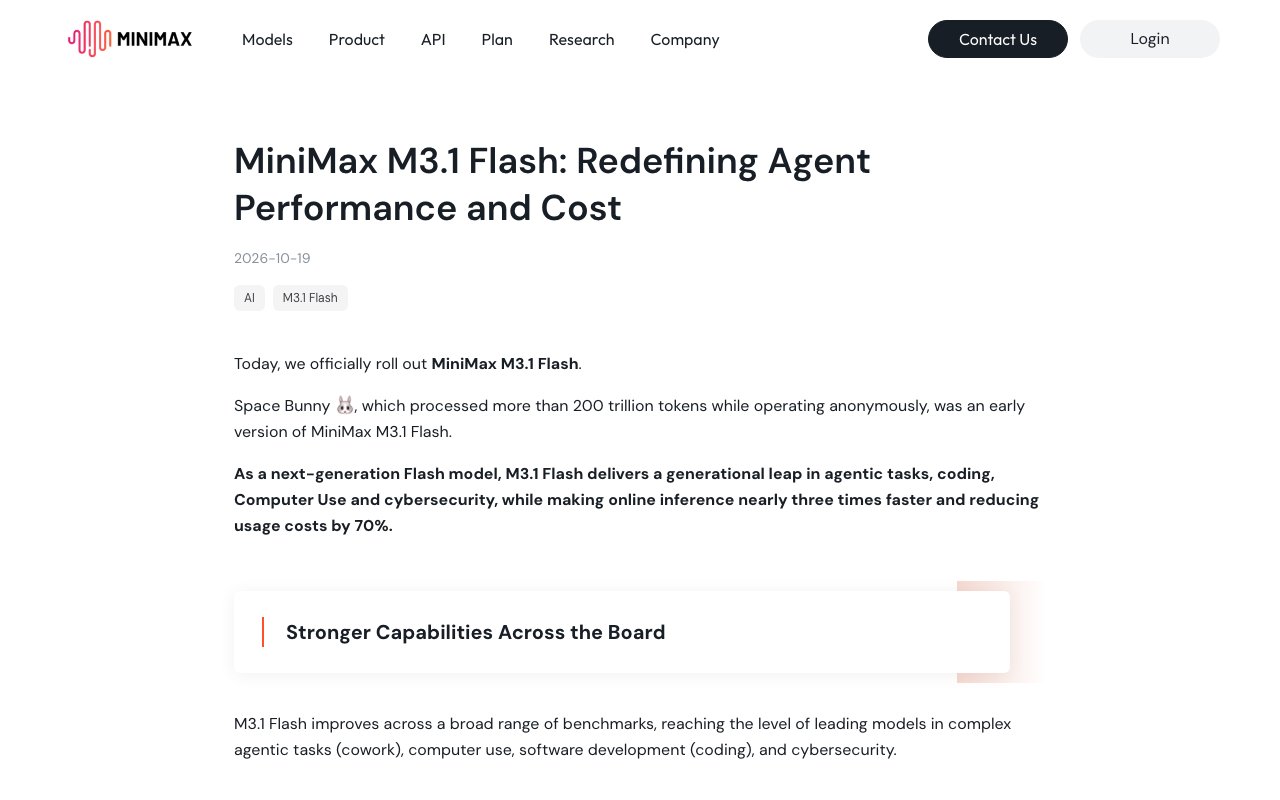
Le schermate mostrano le pagine ufficiali alla data indicata e possono differire da quelle alla pubblicazione. Seleziona un’immagine per ingrandirla.
Il 19 ottobre 2026 l'azienda cinese di IA MiniMax ha lanciato "MiniMax M3.1 Flash", un modello linguistico leggero e veloce. MiniMax è anche la società che gestisce il servizio di generazione video "Hailuo AI". Secondo l'azienda, il nuovo modello è forte nella programmazione e negli usi da "agente", in cui l'IA pianifica da sola i passaggi e porta avanti il lavoro, ed è più veloce ed economico da usare rispetto alla generazione precedente.
MiniMax ha inoltre rivelato che "Space Bunny", un misterioso modello offerto senza nome, era una prima versione di M3.1 Flash.
Che tipo di modello è M3.1 Flash
Nelle note di rilascio MiniMax presenta M3.1 Flash come "un modello a pesi aperti molto efficiente per il lavoro di tutti i giorni". Pesi aperti significa che i pesi del modello (i dati del modello già addestrato) vengono resi pubblici, così che chiunque possa eseguirlo nel proprio ambiente. MiniMax precisa però che i pesi saranno "pubblicati in seguito": al momento dell'annuncio non erano ancora disponibili. L'azienda prevede anche di lanciare più avanti una versione superiore, "Pro".
Secondo il blog ufficiale di MiniMax, il nuovo modello migliora molto rispetto alla generazione precedente nei seguenti ambiti.
- Attività da agente
- Programmazione
- Uso del computer (quando l'IA guarda lo schermo e usa mouse e tastiera)
- Sicurezza informatica
Sul fronte della sicurezza, MiniMax spiega che il modello è stato valutato dai suoi esperti interni e ha ottenuto buoni risultati nella revisione del codice, nella correzione delle vulnerabilità, nei test di penetrazione e nell'analisi di programmi dannosi.
MiniMax ha lanciato il suo modello linguistico di punta, "MiniMax M3", il 1° giugno 2026. M3.1 Flash è una nuova versione della serie M3, e "Flash" nel nome indica che si tratta della versione leggera e veloce. Il blog ufficiale non indica chiaramente il nome del modello della "generazione precedente" usato per il confronto.
Velocità e costi
MiniMax descrive velocità e costi in questo modo.
- L'inferenza (l'elaborazione che produce le risposte) nei servizi reali è circa tre volte più veloce rispetto alla generazione precedente
- La velocità di output supera i 200 token al secondo e resta sopra i 170 token anche nella mediana (P50)
- Il costo complessivo delle attività da agente è inferiore del 70% rispetto alla generazione precedente
I token sono le piccole unità con cui l'IA gestisce il testo. I prezzi per milione di token sono i seguenti.
- Input: 0,15 dollari
- Output: 0,60 dollari
- Input in cache (uno sconto quando si invia ripetutamente lo stesso contenuto): 0,015 dollari
Nel listino di MiniMax, il modello superiore MiniMax M3 (per input fino a 512.000 token) costa 0,30 dollari per l'input e 1,20 dollari per l'output. M3.1 Flash costa la metà.
I risultati delle valutazioni
Ecco i principali risultati pubblicati da MiniMax. Sono tutti dati presentati da MiniMax nel proprio annuncio, e il blog ufficiale non riporta i punteggi dei modelli di altre aziende con cui è stato confrontato.
- DeepSWE v1.1 (sviluppo software): 73,7%
- BankerToolBench (uso di strumenti nel lavoro finanziario): 76,2
- OSWorld V2 (uso del computer): 61,7
- Agents' Last Exam (compiti difficili per agenti): 29,6
- CyberGym (sicurezza informatica): 82%
MiniMax afferma che il modello è primo tra i modelli cinesi su OSWorld V2 e Agents' Last Exam. Dice inoltre che si è piazzato ai primi posti anche su AutomationBench-AA, che misura l'automazione delle attività aziendali.
L'identità del modello anonimo "Space Bunny"
Nel mondo dell'IA capita che le aziende pubblichino prima un "modello stealth" senza il proprio nome, osservino la reazione degli utenti e solo dopo facciano l'annuncio ufficiale. MiniMax ha rivelato che "Space Bunny", che operava in forma anonima, era una prima versione di M3.1 Flash e che, mentre il suo nome restava nascosto, ha elaborato oltre 200.000 miliardi di token.
Secondo la stampa, Space Bunny era disponibile su "OpenRouter", un servizio che permette di usare molti modelli di IA in un unico posto.
Dove si può usare
M3.1 Flash è disponibile in questi tre modi.
- L'API di MiniMax (il meccanismo con cui gli sviluppatori richiamano il modello dalle proprie app)
- Il piano in abbonamento di MiniMax, "M Plan"
- "MiniMax Code", un'app desktop per la programmazione
Il numero di parametri (una misura delle dimensioni del modello), la quantità di testo che può leggere in una volta (il contesto) e la licenza non sono stati resi noti nelle pagine ufficiali. Non ci sono nemmeno indicazioni specifiche sull'uso dal Giappone o sul supporto alla lingua giapponese.
Il punto di vista di CoAI
M3.1 Flash è un modello che punta tutto su velocità e costi bassi, a metà prezzo rispetto al modello superiore. Per gli sviluppatori che vogliono eseguire molte attività di programmazione e da agente, è un'opzione per contenere i costi. Le aziende cinesi continuano a lanciare modelli leggeri ed economici, come V4.1-Flash-1017 di DeepSeek, e la concorrenza in questo campo si fa sempre più accesa.
D'altra parte, i dati delle valutazioni sono stati presentati dalla stessa MiniMax, e il blog ufficiale non include confronti con i modelli di altre aziende. Non si conoscono ancora nemmeno i tempi di pubblicazione dei pesi, la licenza e la lunghezza del contesto. Per l'uso professionale conviene provarlo sulle proprie attività e verificare anche le condizioni d'uso, ad esempio dove vengono trattati i dati inviati.
