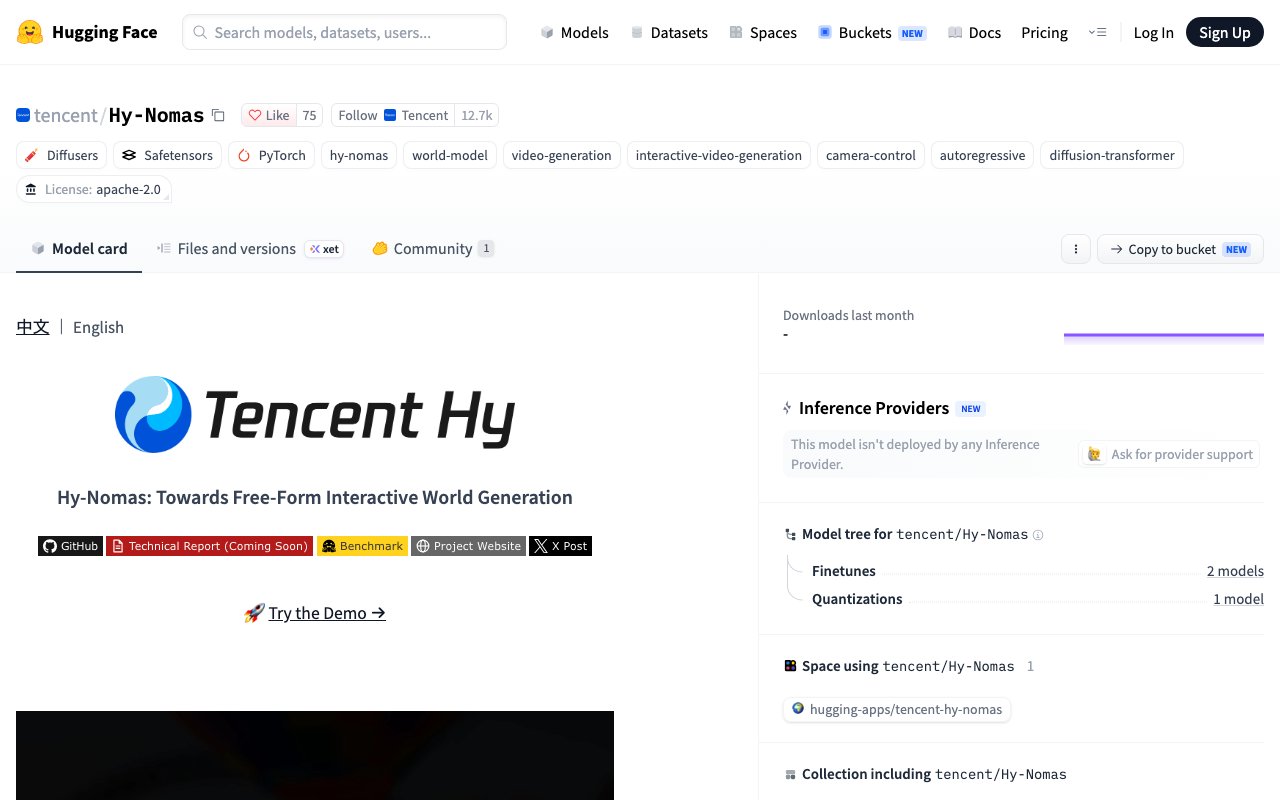
Le schermate mostrano le pagine ufficiali alla data indicata e possono differire da quelle alla pubblicazione. Seleziona un’immagine per ingrandirla.
Il 24 ottobre 2026 (ora cinese e giapponese), il team Hunyuan di Tencent ha annunciato sul suo account X ufficiale Hy-Nomas, un modello di IA che costruisce senza sosta un «mondo» video. Combinando istruzioni testuali e movimenti di camera, genera la scena segmento per segmento e, strada facendo, consente di aggiungere oggetti o cambiare stile visivo e movimenti. I pesi del modello e il codice sono disponibili su Hugging Face e GitHub, con la licenza Apache-2.0, favorevole all'uso commerciale.
Che cos'è Hy-Nomas
Hy-Nomas è un'IA che Tencent definisce un «modello interattivo di generazione di mondi video». Una normale IA di generazione video crea un video di durata fissa a partire da una sola istruzione. Hy-Nomas, invece, crea il video in brevi segmenti e accetta ogni volta una nuova istruzione.
Secondo la scheda del modello, durante la generazione è possibile:
- Aggiungere oggetti, cambiare lo stile visivo o la scena, o indicare movimenti agli elementi presenti, tramite testo
- Specificare movimenti di camera per spostarsi nel mondo
- Alternare istruzioni testuali e comandi di camera
Il modello dispone di un meccanismo che ricorda il contenuto dei segmenti precedenti (una memoria del mondo), che secondo Tencent mantiene coerenti aspetto e disposizione anche quando la scena prosegue.
Prestazioni e requisiti
La versione veloce pubblicata produce video da 720 pixel di altezza per 1280 di larghezza a 24 fotogrammi al secondo, con 8 passaggi di elaborazione. Secondo la descrizione su GitHub, supporta impostazioni a 4, 6 e 8 passaggi.
La configurazione standard presuppone otto GPU. Tuttavia, combinando la quantizzazione INT8, che alleggerisce il modello, con lo spostamento di parte dell'elaborazione sulla CPU, Tencent offre una configurazione in grado di funzionare su una sola GPU consumer di NVIDIA, la GeForce RTX 4090. Va precisato che questa configurazione a una sola GPU riguarda la parte che genera il video; il sistema che arricchisce le istruzioni nella demo web richiede risorse di calcolo a parte.
I 24 fotogrammi al secondo si riferiscono alla riproduzione del video, e non è indicato se la generazione tenga il passo del tempo reale. La scheda del modello non riporta nemmeno il numero di parametri né la durata massima dei video. La testata specializzata estera VP Land ha riferito «8 miliardi di parametri, fino a 60 secondi» citando la pagina del progetto, ma CoAI non ha potuto verificarlo su fonti primarie.
Cosa è stato pubblicato insieme al modello
Oltre al modello vero e proprio, sono stati pubblicati:
- Un LoRA (un piccolo componente per l'addestramento aggiuntivo) per immagini dal taglio cinematografico
- Un LoRA per la robotica (addestrato su dati di un vero robot a due bracci)
- Il codice per addestramento, inferenza e demo, e un sistema per descrivere i dati di addestramento
- Il dataset di valutazione Hy-Nomas-Bench (280 voci)
Tencent spiega che il LoRA per la robotica serve a migliorare la capacità di riprodurre i movimenti di un robot nel mondo generato, il che lascia intendere che l'azienda pensi non solo alla produzione video ma anche alla simulazione robotica. È disponibile anche una demo online da provare nel browser.
Licenza e valutazione
La licenza è Apache-2.0 e si applica non solo al codice ma anche ai pesi del modello. I componenti di terze parti inclusi (come il modello Qwen usato per leggere il testo) restano però soggetti alle rispettive licenze originali. Il file LICENSE precisa che non vengono aggiunte ulteriori restrizioni. Alcuni modelli Hunyuan precedenti erano stati rilasciati con licenze proprietarie che escludevano alcune regioni o fissavano un tetto al numero di utenti. Colpisce quindi la scelta, questa volta, di una formula così aperta.
D'altra parte, non sono stati diffusi dati sulle prestazioni. Hy-Nomas-Bench verifica quattro aspetti, ovvero più turni di istruzioni testuali, movimento della camera, combinazione di istruzioni e camera e memoria dei luoghi, ma non sono stati pubblicati punteggi né confronti con altri modelli. Il rapporto tecnico risulta ancora «in arrivo».
La corsa ai modelli di mondo
Un modello di mondo è un'IA che crea, a partire da testo o altri input, un mondo virtuale in cui ci si può muovere. Oltre che per la produzione di giochi e video, questi modelli attirano attenzione per l'addestramento in ambienti virtuali dell'IA di robot e auto a guida autonoma.
Tencent aveva già pubblicato la serie di modelli di mondo HY-World, e HY-World 2.0, ad aprile, era un modello che generava dati 3D modificabili. Hy-Nomas non genera dati 3D, ma amplia il mondo concatenando il video un po' alla volta, e si distingue per la possibilità di inserire istruzioni testuali tutte le volte che si vuole. Non è stato presentato alcun confronto di prestazioni con HY-World.
Il punto di vista di CoAI
Hy-Nomas è un tentativo di portare l'IA di generazione video dal «si crea una volta e basta» al «si aggiungono istruzioni mentre si crea». Poiché pesi e codice sono pubblicati con Apache-2.0 ed esiste una configurazione che funziona con una sola GPU consumer, ricercatori e sviluppatori possono provarlo facilmente sulle proprie macchine.
Tuttavia non ci sono ancora né dati sulle prestazioni né il rapporto tecnico, quindi la sua qualità si può giudicare solo dalle demo e dalle spiegazioni di Tencent. Chi vuole provarlo farebbe bene a verificarne prima il comportamento nella demo online o con impostazioni leggere, e ad aspettare il rapporto tecnico e valutazioni esterne prima di usarlo sul serio.