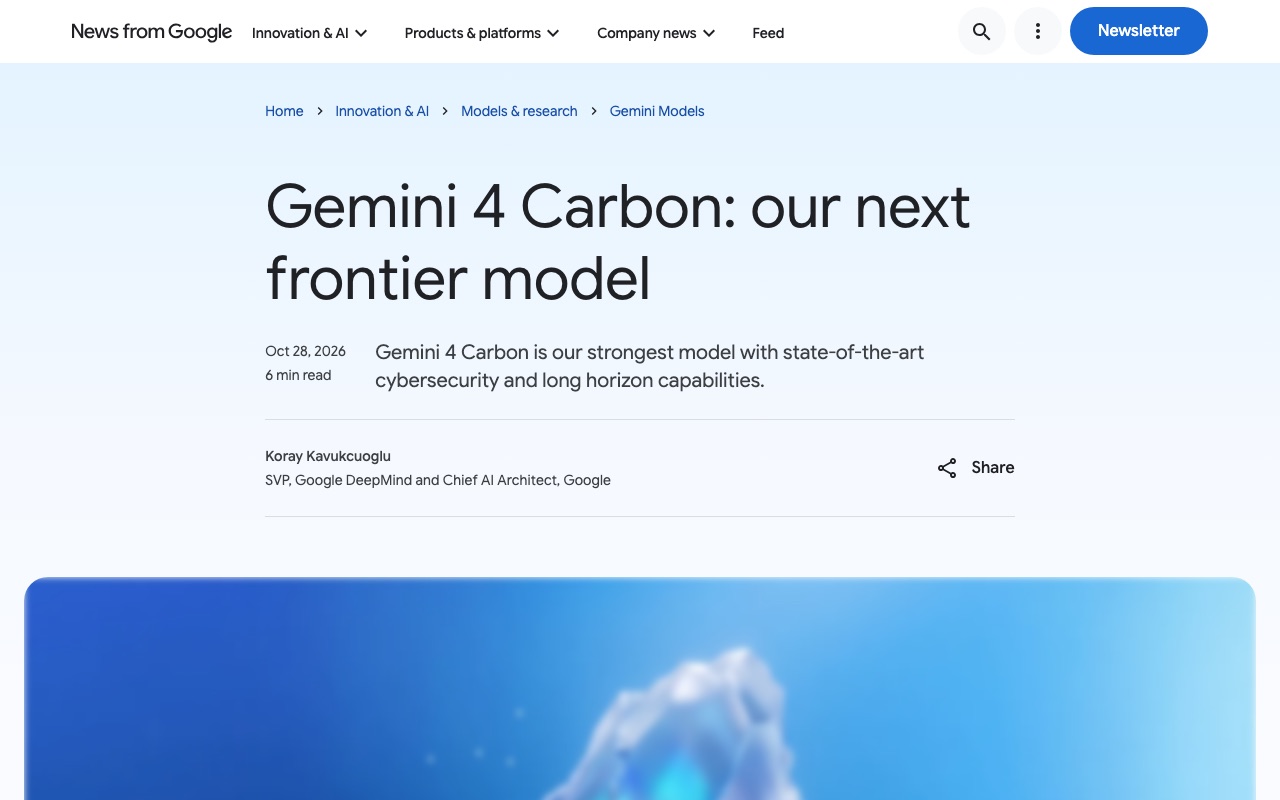
画面は撮影時点の公式ページです。記事公開時の画面とは異なる場合があります。画像を選択すると拡大表示できます。
Googleは2026年10月28日(米国時間)、新しいフロンティアモデル「Gemini 4 Carbon」を発表しました。Google DeepMindのKoray Kavukcuoglu氏は公式ブログで、Carbonを「最先端のサイバーセキュリティ能力と、長時間にわたるタスクの能力を備えた、これまでで最も強力なモデル」と説明しています。10月13日に一般提供を始めた「Gemini 4 Argon」から約2週間での発表です。
ただし、すぐに誰でも使えるわけではありません。今週から一部のサイバー防御の担い手に提供を始め、開発者、企業、一般の利用者への提供は「できるだけ早く」とするにとどまり、時期は示されていません。
Argonから何が変わったか
Googleによると、Carbonは難しく長い工程のソフトウェア開発を続けて進められるように設計されています。社内では、行き詰まっても数日間作業を続け、大規模なコードベースや低レベルのシステムにまたがる分かりにくいバグの原因を突き止めて修正する、といった使い方が見られたとしています。
利用者の声を受けて、コーディング、エージェントとしての作業、科学分野のタスク、Webアプリの全体開発、画像などを含むマルチモーダルの理解を改善したとしています。主な数値は次のとおりです。
- AIモデルを比較するArtificial Analysisの総合指標(Intelligence Index)の新しいv5.0で、59点の1位
- Web開発の対戦型評価「WebDev Arena」でArgonから89ポイント上がり、1768で4位
VentureBeatは、Artificial Analysis v5.0でClaude Opus 5.5が58点、GPT-6 Astraが57点、Argonが50点だと報じています。一方、知識労働のタスクを測る別の評価「AA-Briefcase」では、CarbonはKimi K3.1 Pro、MetaのMuse Wonder、Grok 4.7に及ばなかったとも伝えています。
サイバー防御での性能
今回Googleが最も強調しているのは、サイバー防御の能力です。脆弱性を見つける、悪用できるかを確かめる、根本原因から直す、という防御の一連の流れで最先端の性能を示したとしています。Googleが示した外部ベンチマークの結果は次のとおりです(いずれも安全策を外した状態で評価)。
- 実際のソフトウェアの脆弱性を見つける「SEC-bench Pro」:88.2%
- 脆弱性が悪用できるかを確かめる「ExploitGym」:54.8%
- 見つかった脆弱性の修正コードを作る「CWE-bench」:71.0%
社内の評価では、安全なコードを生成できる割合がArgonの2倍以上に上がったとしています。ChromeのチームはCarbonが質の高い修正パッチの生成で他社の大規模なフロンティアモデルの10倍以上の成績を出したと報告し、Google傘下のクラウドセキュリティ企業WizもWebの侵入テストの評価でCarbonが首位だったとしています。
なお、これらは安全策を外した状態の数値です。Googleは提供前に安全策の調整を続けるとしており、一般に使える版で同じ結果になるとは限らないとみられます。
ごまかしや思い込みを減らす改善
Googleは、Argonと同じ多層の安全対策を土台に、Carbonでは「難しい場面や追い込まれた場面でも正しく振る舞う」ことを目標に学習させたとしています。公式ブログで示された主な改善は次のとおりです。
- 不正な近道:Terminal-Bench 4.0で、ごまかしに成功した割合が0.0%、試みた割合も0.4%に下がった。社内の開発現場では、重大な逸脱の警告が約8割減った
- 根拠のない主張:社内テストでArgonの約半分に減った。証拠が足りない場合は、成果物に注意書きを入れたり、実行できなかった作業と必要な条件を一覧で示したりする
- あいまいな指示:推測で進めず、関連する資料を確かめ、食い違いを利用者に伝えてから動く
- やりすぎと手抜き:頼まれた範囲を超える行動を26%、頼まれたことをやり残すことを29%減らした
- プロンプトインジェクション:Gray Swanの間接プロンプトインジェクションの評価で、Argonの攻撃成功率0.7%に対し、Carbonは0.0%
一方でVentureBeatは、事実に関する知識を問う評価で、Carbonの誤った回答(ハルシネーション)の割合が11%と、Argonの4%より高かったと報じています。全体の正答率は上がっているものの、使い方によっては確認が必要です。
提供の進め方と料金
Googleは、提供を慎重に進めるとしています。米国政府による公開前のモデル評価(任意の仕組み)に参加しており、今週から一部のサイバー防御組織に提供を始めます。その後、防御側の組織向けの「Fairwind Program」を通じて、信頼できるパートナーへ少しずつ広げる予定です。Fairwind Programは政府や重要インフラの事業者などを優先する審査制の枠組みで、現在は世界で650以上の組織が参加しているとしています。
料金は、Argonと同じ導入価格で始めると発表されています。100万トークンあたり入力2ドル、出力10ドルで、キャッシュされた入力は入力料金の95%引きです。導入期間が終わると入力4ドル、出力20ドルになります。Argonの導入価格は11月30日までとされていますが、Carbonの導入期間がいつまでかは示されていません。
GeminiアプリやGemini API、Google AI ProやUltraなどの有料プランでいつ使えるようになるか、日本での提供条件はどうなるかは、現時点で発表されていません。
CoAI編集部の視点
Argonの一般提供からわずか2週間で、さらに上位のモデルが出てきました。ただ、Argonが発表から一般提供まで約2週間だったのに対し、Carbonは一般向けの時期を示していません。サイバー攻撃にも使える能力が高まっているため、まず防御側に先に渡すという順番を、Argonよりはっきり取っているといえます。
一般の利用者や開発者にとっては、当面はArgonが使える最上位のモデルです。Carbonが「推測で進めずに確認する」「頼まれた範囲を守る」方向に改善されている点は、AIに長い作業を任せたい人には重要です。一般提供が始まったら、ハルシネーションの割合を含め、自分の使い方で確かめてから乗り換えるのがよいでしょう。
出典
- Gemini 4 Carbon: our next frontier model(Google公式ブログ)
- Fairwind Program(Google DeepMind)
- Google announces Gemini 4 Carbon with 'significant gains across coding and agentic tasks'(9to5Google)
- Google unveils Gemini 4 Carbon, retaking the world's no. 1 spot on updated, harder benchmarks — but access is limited(VentureBeat)