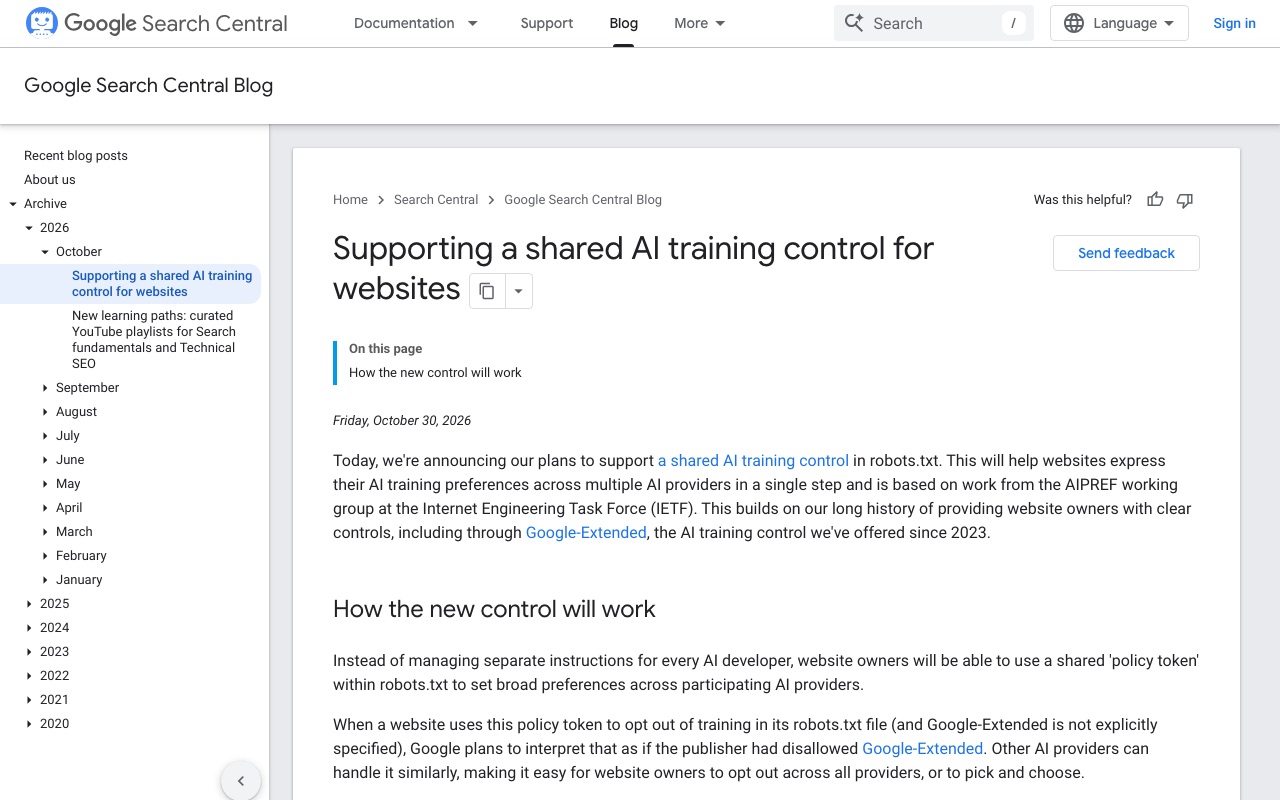
촬영일 기준 공식 페이지이며 기사 게시 당시와 다를 수 있습니다. 이미지를 선택하면 확대할 수 있습니다.
OpenAI, Google, Microsoft, Anthropic 4개사는 2026년 10월 30일(미국 시간), 웹사이트 운영자가 자기 사이트의 콘텐츠를 생성형 AI 학습에 사용해도 되는지를 robots.txt의 공통 표기로 전달할 수 있는 방식을 지원한다고 발표했습니다. 지금까지는 AI 학습을 거부하려면 GPTBot이나 Google-Extended처럼 회사별 이름을 하나씩 적어야 했지만, 앞으로는 한 곳의 표기로 지원하는 회사들에 한꺼번에 의사를 전달할 수 있게 됩니다.
작동 방식: robots.txt에 '__usage_ai-training'을 쓴다
바탕이 된 것은 Anthropic의 Kevin Kelley가 같은 날 IETF(인터넷 기술 표준을 논의하는 단체)에 제출한 문서 'Machine-Readable Training Preference Signal'입니다. robots.txt에서 보통 크롤러 이름을 적는 'User-Agent' 줄에 공통 토큰 '__usage_ai-training'을 쓰고, 그 아래의 Disallow(거부)와 Allow(허용)로 학습에 써도 되는지를 경로별로 나타냅니다.
문서에 실린 예시는 다음과 같습니다.
- User-Agent: __usage_ai-training
- Disallow: /
- Allow: /press-kit/
이 경우 사이트 전체에 대해 학습에 쓰이지 않기를 바란다는 의사를 밝히고, /press-kit/ 아래만 학습에 써도 된다고 표시합니다.
문서는 다음 사항도 정하고 있습니다.
- 'User-Agent: *'(모든 크롤러를 대상으로 하는 지정)는 이 토큰에 적용되지 않는다. 학습을 거부하려면 이 토큰을 명시해야 한다
- 여기서 말하는 학습은 생성형 AI 모델의 파라미터를 바꾸는 데 쓰는 것을 뜻한다. 분류나 순위 매기기에만 쓰는 모델은 대상이 아니다
- 새로운 명령이나 문법은 추가하지 않고, 기존 robots.txt 표기법을 그대로 쓴다
- GPTBot 등 각사의 크롤러 이름을 지정한 표기의 의미는 바뀌지 않는다
다만 이 문서는 IETF의 정식 표준이 아니며, 개인 제안으로 제출된 단계입니다.
각사의 지원 현황
4개사 모두 기존의 회사별 설정은 앞으로도 쓸 수 있다고 하면서 공통 토큰을 지원하겠다고 밝혔습니다. 다만 지원 시기와 처리 방식은 회사마다 다릅니다.
- Anthropic: 문서를 제출한 회사로, 이미 지원을 시작한 것으로 보도됐다
- OpenAI: 앞으로 몇 달 안에 지원한다. 기존 설정을 대체하는 것은 아니라고 밝혔다
- Microsoft(Bing): 2027년 2월 1일부터 크롤링할 때 이 지정을 반영한다
- Google: 2027년 지원을 목표로 한다
Google의 설명에는 주의해야 할 점이 있습니다. 사이트가 공통 토큰으로 학습을 거부하고 Google-Extended에 대해서는 아무것도 적지 않은 경우, Google은 Google-Extended도 거부된 것으로 취급할 예정입니다. Google-Extended는 Gemini 모델 학습뿐 아니라 Gemini 앱에서 답변의 근거로 쓰이는지와도 관련됩니다. Google은 Google-Extended를 명시적으로 허용한 사이트는 계속 Gemini 앱 답변의 근거로 표시되고 클릭될 수 있다고 밝혔습니다.
Bing은 '답변의 근거' 거부 설정도 추가
Microsoft는 같은 날, 학습과는 별도로 Bing이나 Copilot 등 AI 답변의 근거(그라운딩)로 페이지가 쓰일지를 선택할 수 있는 설정도 발표했습니다.
- 학습: robots.txt의 공통 토큰 외에, 페이지별로 meta 태그(예: <meta name="Bingbot" content="ai-training:disallow">)나 HTTP 헤더로도 지정할 수 있다. 페이지별 지정은 robots.txt의 지정보다 우선한다
- 답변의 근거: 페이지별로 모두 거부하는 'disallow'나, Microsoft 자사 제품 이외에서의 이용만 거부하는 'disallowextended'를 선택할 수 있다
Microsoft는 이 설정들로 Bing의 일반 검색 결과에 게재될 수 있는 대상인지는 바뀌지 않는다고 밝혔습니다. 반면 답변의 근거로 쓰이는 것을 거부하면 AI가 만드는 답변 안에서 페이지가 표시되기 어려워진다고 설명했습니다. 또한 그동안 AI 관련 의사 표시로 취급해 온 'NoArchive'와 'NoCache'는 2027년 3월 1일 이후 그 목적으로는 읽지 않게 됩니다. 이를 위한 전환 조치로, 2026년 12월 15일부터 그 시점에 NoArchive나 NoCache를 쓰고 있는 사이트에 한해 Bing Webmaster Tools에서 답변의 근거에 관한 임시 설정을 할 수 있게 됩니다.
CoAI 편집부의 시각
지금까지 AI 학습을 거부하고 싶은 사이트는 새 크롤러가 나올 때마다 robots.txt에 이름을 추가해야 했습니다. 주요 4개사가 같은 표기를 지원하면서 그 수고가 크게 줄어듭니다. 생성형 AI 학습과 AI 답변의 근거로서의 이용을 나눠서 생각할 수 있는 설정이 확산되는 것도 사이트 운영자에게는 진전입니다.
다만 모든 것이 곧바로 바뀌는 것은 아닙니다. Google과 Microsoft의 지원은 2027년부터이고, OpenAI도 '앞으로 몇 달 안'이라고만 하고 구체적인 날짜는 제시하지 않았습니다. 또한 이 방식은 어디까지나 의사를 전달하는 것으로, 지원하지 않는 회사에 지키게 할 강제력은 없습니다. Google의 경우 학습만 거부했다고 생각하더라도 Google-Extended를 허용해 두지 않으면 Gemini 앱의 답변에 쓰이지 않게 된다는 점에 주의해야 합니다. 당분간은 기존의 회사별 표기도 남겨 두는 것이 안전합니다.
출처
- Machine-Readable Training Preference Signal(IETF Datatracker)
- Making it easier for websites to express AI training preferences(OpenAI)
- Supporting a shared AI training control for websites(Google Search Central 블로그)
- Your content, your choice: clearer preferences for training and grounding(Microsoft Bing 블로그)
- Google, OpenAI, Microsoft, and Anthropic back a shared robots.txt AI training signal(Coywolf)