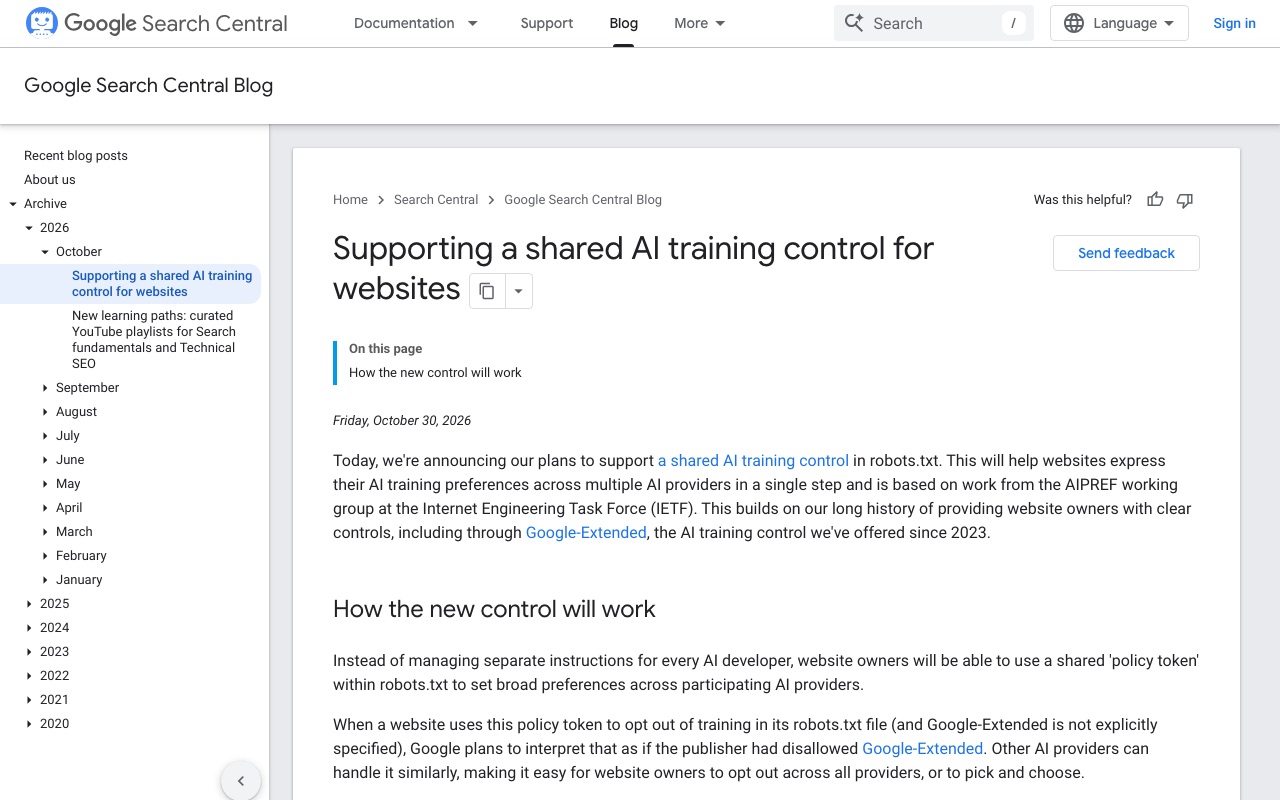
As capturas mostram as páginas oficiais na data indicada e podem diferir das páginas na publicação. Selecione uma imagem para ampliá-la.
Em 30 de outubro de 2026 (horário dos EUA), OpenAI, Google, Microsoft e Anthropic anunciaram que vão dar suporte a um mecanismo que permite aos responsáveis por sites indicar, com uma forma comum de escrever o robots.txt, se querem ou não que o conteúdo do site seja usado para treinar IA generativa. Até agora, para recusar o treinamento de IA era preciso escrever, um por um, os nomes específicos de cada empresa, como GPTBot ou Google-Extended; daqui em diante, uma única entrada bastará para comunicar a preferência a todas as empresas que derem suporte a ela.
Como funciona: escrever "__usage_ai-training" no robots.txt
A base é o documento "Machine-Readable Training Preference Signal", que Kevin Kelley, da Anthropic, apresentou no mesmo dia à IETF (a organização onde são discutidos os padrões técnicos da internet). Na linha "User-Agent" do robots.txt, onde normalmente se escreve o nome de um rastreador, coloca-se o token comum "__usage_ai-training" e, abaixo dele, indica-se caminho por caminho, com Disallow (recusar) e Allow (permitir), se o conteúdo pode ser usado para treinamento.
O exemplo que aparece no documento é o seguinte.
- User-Agent: __usage_ai-training
- Disallow: /
- Allow: /press-kit/
Nesse caso, o site indica que não quer que nada do seu conteúdo seja usado para treinamento, exceto o que está em /press-kit/, que pode ser usado.
O documento também define os seguintes pontos.
- "User-Agent: *" (a indicação voltada a todos os rastreadores) não se aplica a esse token. Para recusar o treinamento, é preciso escrever esse token de forma explícita
- Treinamento, aqui, significa usar o conteúdo para alterar os parâmetros de um modelo de IA generativa. Modelos usados apenas para classificação ou ordenação ficam de fora
- Não são adicionadas novas diretivas nem nova sintaxe; usa-se a forma de escrever o robots.txt que já existe
- O significado das entradas que indicam o nome do rastreador de cada empresa, como GPTBot, não muda
Vale lembrar que esse documento não é um padrão oficial da IETF, e sim, por enquanto, uma proposta apresentada em caráter individual.
O que cada empresa vai fazer
As quatro empresas anunciaram que vão dar suporte ao token comum e afirmaram que as configurações próprias de cada uma continuarão funcionando. Porém, o prazo e a forma de aplicação variam de empresa para empresa.
- Anthropic: é a empresa que apresentou o documento e, segundo relatos, já começou a dar suporte a ele
- OpenAI: vai dar suporte nos próximos meses. Afirma que ele não substitui as configurações atuais
- Microsoft (Bing): a partir de 1º de fevereiro de 2027, vai considerar essa indicação ao rastrear
- Google: pretende dar suporte em 2027
A explicação do Google traz um ponto que exige atenção. Se um site recusar o treinamento com o token comum e não disser nada sobre o Google-Extended, o Google pretende tratar o Google-Extended como recusado também. O Google-Extended afeta não só o treinamento dos modelos Gemini, mas também se o conteúdo é usado como base das respostas no app Gemini. O Google afirma que os sites que permitirem explicitamente o Google-Extended continuarão aparecendo como base das respostas no app Gemini e poderão receber cliques.
O Bing também adiciona uma configuração para recusar o uso como "base das respostas"
No mesmo dia, a Microsoft também anunciou uma configuração, separada da de treinamento, que permite escolher se uma página pode ser usada como base (grounding) das respostas de IA no Bing, no Copilot e em outros serviços.
- Treinamento: além do token comum do robots.txt, também é possível indicar página por página com uma meta tag (por exemplo, <meta name="Bingbot" content="ai-training:disallow">) ou com um cabeçalho HTTP. A indicação por página tem prioridade sobre a do robots.txt
- Base das respostas: página por página, é possível escolher "disallow", que recusa tudo, ou "disallowextended", que recusa apenas o uso fora dos produtos da própria Microsoft
A Microsoft afirma que essas configurações não mudam se a página pode ou não aparecer nos resultados de busca comuns do Bing. Por outro lado, explica que recusar o uso como base das respostas faz com que a página tenha menos chance de aparecer nas respostas geradas pela IA. Além disso, a partir de 1º de março de 2027, deixará de ler para esse fim o "NoArchive" e o "NoCache", que até agora tratava como indicações relacionadas à IA. Para a transição, a partir de 15 de dezembro de 2026, somente os sites que estiverem usando NoArchive ou NoCache nesse momento poderão definir no Bing Webmaster Tools preferências temporárias sobre o uso como base das respostas.
A visão do CoAI
Até agora, os sites que queriam recusar o treinamento de IA precisavam acrescentar um nome ao robots.txt toda vez que surgia um novo rastreador. Com as quatro grandes empresas adotando a mesma forma de escrever, esse trabalho diminui bastante. A difusão de configurações que permitem tratar separadamente o treinamento de IA generativa e o uso como base das respostas de IA também é um avanço para os responsáveis por sites.
No entanto, nem tudo vai mudar de imediato. Google e Microsoft só começam em 2027, e a OpenAI disse apenas "nos próximos meses", sem dar uma data específica. Além disso, esse mecanismo serve apenas para comunicar uma preferência e não tem força para obrigar as empresas que não o suportam a cumpri-la. No caso do Google, atenção: mesmo que a intenção seja recusar só o treinamento, se o Google-Extended não for permitido, o conteúdo deixará de ser usado nas respostas do app Gemini. Por enquanto, o mais seguro é manter também as entradas já existentes de cada empresa.
Fontes
- Machine-Readable Training Preference Signal (IETF Datatracker)
- Making it easier for websites to express AI training preferences (OpenAI)
- Supporting a shared AI training control for websites (Google Search Central Blog)
- Your content, your choice: clearer preferences for training and grounding (Microsoft Bing Blogs)
- Google, OpenAI, Microsoft, and Anthropic back a shared robots.txt AI training signal (Coywolf)
Ferramentas mencionadas neste artigo
 ChatGPTA IA conversacional da OpenAI para tirar dúvidas, escrever, resumir, programar e desenvolver ideias.Ver detalhes
 GeminiIA conversacional do Google, que se integra à Busca Google e ao Workspace.Ver detalhes
 ClaudeAssistente de IA conversacional da Anthropic, com pontos fortes na compreensão de textos longos e na geração de textos naturais.Ver detalhes
 Microsoft CopilotMicrosoft Copilot é um serviço de IA assistente de uso geral que pode ser usado para responder perguntas e pesquisas.Ver detalhes