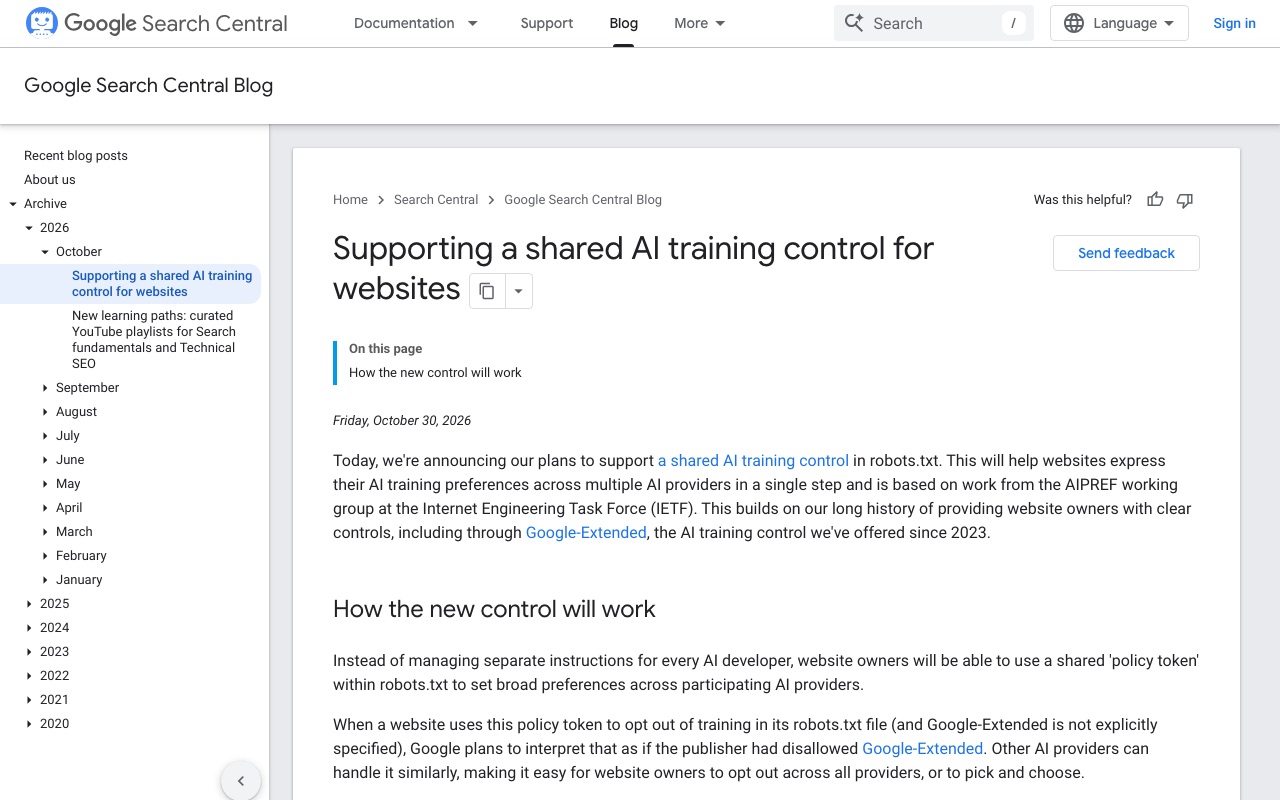
ภาพแสดงหน้าอย่างเป็นทางการ ณ วันที่ถ่าย ซึ่งอาจแตกต่างจากวันที่เผยแพร่บทความ เลือกภาพเพื่อขยาย
OpenAI, Google, Microsoft และ Anthropic ประกาศเมื่อวันที่ 30 ตุลาคม 2026 (ตามเวลาสหรัฐฯ) ว่าจะรองรับกลไกที่ให้ผู้ดูแลเว็บไซต์แจ้งได้ด้วยรูปแบบการเขียนร่วมใน robots.txt ว่าต้องการให้นำเนื้อหาในเว็บไซต์ของตนไปใช้ฝึก AI แบบสร้างสรรค์หรือไม่ ที่ผ่านมา หากต้องการปฏิเสธการฝึก AI จะต้องเขียนชื่อเฉพาะของแต่ละบริษัททีละชื่อ เช่น GPTBot หรือ Google-Extended แต่ต่อจากนี้จะสามารถแจ้งความประสงค์ไปยังบริษัทที่รองรับได้พร้อมกันด้วยการเขียนเพียงจุดเดียว
กลไก: เขียน "__usage_ai-training" ใน robots.txt
พื้นฐานของกลไกนี้คือเอกสาร "Machine-Readable Training Preference Signal" ที่ Kevin Kelley จาก Anthropic ยื่นต่อ IETF (องค์กรที่หารือเรื่องมาตรฐานทางเทคนิคของอินเทอร์เน็ต) ในวันเดียวกัน โดยให้เขียนโทเค็นร่วม "__usage_ai-training" ในบรรทัด "User-Agent" ของ robots.txt ซึ่งปกติใช้ระบุชื่อ crawler แล้วใช้ Disallow (ปฏิเสธ) และ Allow (อนุญาต) ด้านล่างเพื่อระบุเป็นรายพาธว่าอนุญาตให้ใช้ฝึกได้หรือไม่
ตัวอย่างที่ระบุไว้ในเอกสารมีดังนี้
- User-Agent: __usage_ai-training
- Disallow: /
- Allow: /press-kit/
ในกรณีนี้ เว็บไซต์แสดงความประสงค์ว่าไม่ต้องการให้ใช้เนื้อหาทั้งเว็บไซต์ในการฝึก ยกเว้นเฉพาะส่วนที่อยู่ใต้ /press-kit/ ที่อนุญาตให้ใช้ฝึกได้
เอกสารยังกำหนดประเด็นต่อไปนี้ไว้ด้วย
- "User-Agent: *" (การระบุสำหรับ crawler ทั้งหมด) ไม่ครอบคลุมโทเค็นนี้ หากต้องการปฏิเสธการฝึก ต้องระบุโทเค็นนี้อย่างชัดเจน
- การฝึกในที่นี้หมายถึงการใช้เพื่อเปลี่ยนพารามิเตอร์ของโมเดล AI แบบสร้างสรรค์ โมเดลที่ใช้เพียงเพื่อจัดหมวดหมู่หรือจัดอันดับไม่อยู่ในขอบเขต
- ไม่เพิ่มคำสั่งหรือไวยากรณ์ใหม่ ใช้รูปแบบการเขียน robots.txt ที่มีอยู่เดิมตามเดิม
- ความหมายของรายการที่ระบุชื่อ crawler ของแต่ละบริษัท เช่น GPTBot ไม่เปลี่ยนแปลง
อย่างไรก็ตาม เอกสารนี้ยังไม่ใช่มาตรฐานอย่างเป็นทางการของ IETF แต่อยู่ในขั้นข้อเสนอส่วนบุคคล
การรองรับของแต่ละบริษัท
ทั้ง 4 บริษัทประกาศว่าจะรองรับโทเค็นร่วมนี้ โดยระบุว่าการตั้งค่าเฉพาะของแต่ละบริษัทที่มีอยู่เดิมจะยังใช้ได้ต่อไป แต่ช่วงเวลาและวิธีการจัดการแตกต่างกันไปตามบริษัท
- Anthropic: เป็นบริษัทที่ยื่นเอกสาร และมีรายงานว่าเริ่มรองรับแล้ว
- OpenAI: จะรองรับภายในไม่กี่เดือนข้างหน้า โดยระบุว่าไม่ได้มาแทนที่การตั้งค่าที่มีอยู่
- Microsoft (Bing): จะนำการระบุนี้ไปใช้ในการ crawl ตั้งแต่วันที่ 1 กุมภาพันธ์ 2027
- Google: ตั้งเป้ารองรับในปี 2027
คำอธิบายของ Google มีประเด็นที่ต้องระวัง หากเว็บไซต์ปฏิเสธการฝึกด้วยโทเค็นร่วมและไม่ได้เขียนอะไรเกี่ยวกับ Google-Extended ไว้ Google มีแผนจะถือว่า Google-Extended ถูกปฏิเสธด้วย ทั้งนี้ Google-Extended ไม่ได้เกี่ยวข้องเฉพาะกับการฝึกโมเดล Gemini เท่านั้น แต่ยังเกี่ยวข้องกับการที่เนื้อหาจะถูกใช้เป็นหลักอ้างอิงของคำตอบในแอป Gemini หรือไม่ด้วย Google ระบุว่าเว็บไซต์ที่อนุญาต Google-Extended อย่างชัดเจนจะยังคงแสดงเป็นหลักอ้างอิงของคำตอบในแอป Gemini และยังเป็นเป้าหมายให้ผู้ใช้คลิกได้
Bing เพิ่มการตั้งค่าสำหรับปฏิเสธการใช้เป็น "หลักอ้างอิงของคำตอบ" ด้วย
ในวันเดียวกัน Microsoft ยังประกาศการตั้งค่าที่แยกจากการฝึก ให้เลือกได้ว่าจะให้ใช้หน้าเว็บเป็นหลักอ้างอิงของคำตอบ AI (grounding) ใน Bing, Copilot และอื่น ๆ หรือไม่
- การฝึก: นอกจากโทเค็นร่วมใน robots.txt แล้ว ยังระบุเป็นรายหน้าได้ด้วยแท็ก meta (ตัวอย่าง: <meta name="Bingbot" content="ai-training:disallow">) หรือ HTTP header โดยการระบุเป็นรายหน้าจะมีผลเหนือกว่าการระบุใน robots.txt
- หลักอ้างอิงของคำตอบ: เลือกได้เป็นรายหน้าระหว่าง "disallow" ที่ปฏิเสธทั้งหมด หรือ "disallowextended" ที่ปฏิเสธเฉพาะการใช้งานนอกผลิตภัณฑ์ของ Microsoft เอง
Microsoft ระบุว่าการตั้งค่าเหล่านี้ไม่ได้เปลี่ยนแปลงว่าหน้าเว็บจะมีสิทธิ์แสดงในผลการค้นหาปกติของ Bing หรือไม่ แต่ก็อธิบายว่าหากปฏิเสธการใช้เป็นหลักอ้างอิงของคำตอบ หน้าเว็บจะปรากฏในคำตอบที่ AI สร้างขึ้นได้ยากขึ้น นอกจากนี้ "NoArchive" และ "NoCache" ที่ที่ผ่านมาถูกใช้เป็นการแสดงความประสงค์เกี่ยวกับ AI จะไม่ถูกอ่านเพื่อวัตถุประสงค์ดังกล่าวอีกต่อไปตั้งแต่วันที่ 1 มีนาคม 2027 และเพื่อการเปลี่ยนผ่าน ตั้งแต่วันที่ 15 ธันวาคม 2026 เฉพาะเว็บไซต์ที่ใช้ NoArchive หรือ NoCache อยู่ในขณะนั้นจะสามารถตั้งค่าชั่วคราวเกี่ยวกับการใช้เป็นหลักอ้างอิงของคำตอบได้ใน Bing Webmaster Tools
มุมมองของกองบรรณาธิการ CoAI
ที่ผ่านมา เว็บไซต์ที่ต้องการปฏิเสธการฝึก AI ต้องคอยเพิ่มชื่อลงใน robots.txt ทุกครั้งที่มี crawler ใหม่ การที่ 4 บริษัทหลักรองรับรูปแบบการเขียนเดียวกันจะช่วยลดภาระนี้ได้มาก การตั้งค่าที่แยกการฝึก AI แบบสร้างสรรค์ออกจากการใช้เป็นหลักอ้างอิงของคำตอบ AI ที่แพร่หลายขึ้นก็ถือเป็นความก้าวหน้าสำหรับผู้ดูแลเว็บไซต์เช่นกัน
อย่างไรก็ตาม ทุกอย่างจะไม่เปลี่ยนไปในทันที การรองรับของ Google และ Microsoft จะเริ่มในปี 2027 และ OpenAI ก็ระบุเพียงว่า "ภายในไม่กี่เดือนข้างหน้า" โดยไม่ได้ให้วันที่ที่ชัดเจน นอกจากนี้ กลไกนี้เป็นเพียงการแจ้งความประสงค์ ไม่มีอำนาจบังคับบริษัทที่ไม่รองรับให้ปฏิบัติตาม สำหรับ Google ควรระวังว่าแม้ตั้งใจจะปฏิเสธเฉพาะการฝึก แต่หากไม่อนุญาต Google-Extended ไว้ เนื้อหาจะไม่ถูกใช้ในคำตอบของแอป Gemini อีก ในระยะนี้ การคงรายการเฉพาะของแต่ละบริษัทที่มีอยู่เดิมไว้ด้วยจึงปลอดภัยกว่า
แหล่งที่มา
- Machine-Readable Training Preference Signal (IETF Datatracker)
- Making it easier for websites to express AI training preferences (OpenAI)
- Supporting a shared AI training control for websites (Google Search Central Blog)
- Your content, your choice: clearer preferences for training and grounding (Microsoft Bing Blogs)
- Google, OpenAI, Microsoft, and Anthropic back a shared robots.txt AI training signal (Coywolf)
เครื่องมือที่กล่าวถึงในบทความนี้
 ChatGPTAI สนทนาจาก OpenAI ที่ช่วยตอบคำถาม เขียน สรุปเนื้อหา เขียนโค้ด และคิดไอเดียดูรายละเอียด
 GeminiAI สนทนาของ Google ที่เชื่อมต่อกับการค้นหาของ Google และ Workspace ได้ดูรายละเอียด
 Claudeผู้ช่วย AI สนทนาจาก Anthropic ที่โดดเด่นด้านความเข้าใจข้อความยาวและการสร้างข้อความที่เป็นธรรมชาติดูรายละเอียด
 Microsoft CopilotMicrosoft Copilot เป็นบริการ AI ด้านผู้ช่วย AI อเนกประสงค์ ที่นำไปใช้งานได้ เช่น การตอบคำถาม หรือ การค้นหาดูรายละเอียด