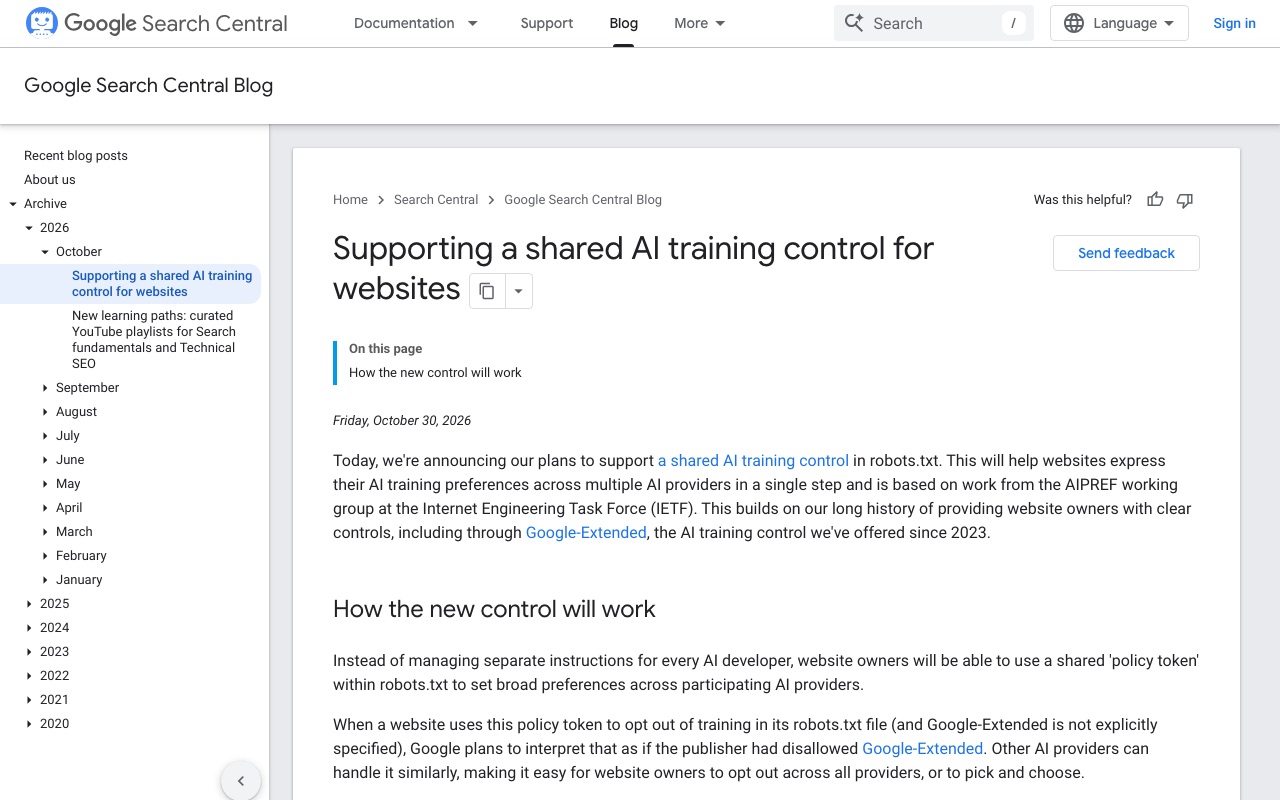
截图展示拍摄日期的官方页面,可能与文章发布时不同。点击图片可放大。
2026年10月30日(美国时间),OpenAI、Google、Microsoft和Anthropic四家公司宣布,将支持一种新机制:网站运营者可以通过robots.txt的统一写法,表明是否希望自己网站的内容被用于生成式AI训练。此前,要拒绝AI训练,需要逐一写上GPTBot、Google-Extended等各家公司的爬虫名称;今后,只需一处写法,就能一次性向所有支持该机制的公司表达意愿。
机制:在robots.txt中写入“__usage_ai-training”
这一机制的基础,是Anthropic的Kevin Kelley当天向IETF(讨论互联网技术标准的组织)提交的文件“Machine-Readable Training Preference Signal”。在robots.txt中通常填写爬虫名称的“User-Agent”一行写入统一令牌“__usage_ai-training”,再通过其下方的Disallow(拒绝)和Allow(允许),按路径表明内容是否可用于训练。
文件中给出的示例如下。
- User-Agent: __usage_ai-training
- Disallow: /
- Allow: /press-kit/
在这个例子中,网站表明不希望整个网站的内容被用于训练,只允许/press-kit/以下的内容用于训练。
文件还规定了以下几点。
- “User-Agent: *”(针对所有爬虫的指定)不适用于该令牌。要拒绝训练,必须明确写出该令牌
- 这里所说的训练,是指用于改变生成式AI模型的参数。仅用于分类或排序的模型不在范围内
- 不新增指令或语法,直接沿用现有的robots.txt写法
- 指定GPTBot等各家爬虫名称的写法,其含义保持不变
需要注意的是,该文件并不是IETF的正式标准,目前仍处于以个人提案形式提交的阶段。
各家公司的支持情况
四家公司均表示,现有的各公司专属设置今后仍可继续使用,同时将支持这一统一令牌。不过,支持的时间和处理方式因公司而异。
- Anthropic:提交该文件的公司,据报道已开始支持
- OpenAI:将在未来几个月内支持,并表示这不会取代现有设置
- Microsoft(Bing):自2027年2月1日起,在抓取时反映这一指定
- Google:目标是在2027年支持
Google的说明中有一点需要注意。如果网站用统一令牌拒绝训练,而对Google-Extended未作任何说明,Google计划将Google-Extended也视为被拒绝。Google-Extended除了涉及Gemini模型的训练,还关系到内容是否会在Gemini应用中被用作回答的依据。Google表示,明确允许Google-Extended的网站,将继续作为Gemini应用回答的依据显示,并可被点击。
Bing还新增了拒绝用作“回答依据”的设置
同一天,Microsoft还发布了一项与训练分开的设置,网站可以选择页面是否被用作Bing、Copilot等AI回答的依据(grounding)。
- 训练:除robots.txt的统一令牌外,还可以按页面通过meta标签(例:<meta name="Bingbot" content="ai-training:disallow">)或HTTP头指定。按页面的指定优先于robots.txt的指定
- 回答依据:可按页面选择全部拒绝的“disallow”,或仅拒绝Microsoft自有产品以外用途的“disallowextended”
Microsoft表示,这些设置不会改变网页是否有资格出现在Bing常规搜索结果中。但它也说明,如果拒绝用作回答依据,页面在AI生成的回答中出现的可能性会降低。此外,过去被视为AI相关意愿表达的“NoArchive”和“NoCache”,自2027年3月1日起将不再按这一用途读取。为便于过渡,自2026年12月15日起,仅限届时正在使用NoArchive或NoCache的网站,可以在Bing Webmaster Tools中进行有关回答依据的临时设置。
CoAI编辑部观点
此前,想要拒绝AI训练的网站,每当出现新的爬虫,就得在robots.txt中补写名称。四家主要公司支持同一种写法,将大大减少这方面的工作量。能够把生成式AI训练和用作AI回答依据分开考虑的设置逐渐普及,对网站运营者来说也是一种进步。
不过,一切并不会立即切换。Google和Microsoft要到2027年才开始支持,OpenAI也只表示“未来几个月内”,并未给出具体日期。而且,这一机制只是传达意愿,对未支持的公司没有强制约束力。就Google而言,需要注意的是:即便本意只是拒绝训练,如果不允许Google-Extended,内容也将不再被用于Gemini应用的回答。目前,稳妥的做法是同时保留现有的各公司专属写法。
资料来源
- Machine-Readable Training Preference Signal(IETF Datatracker)
- Making it easier for websites to express AI training preferences(OpenAI)
- Supporting a shared AI training control for websites(Google Search Central博客)
- Your content, your choice: clearer preferences for training and grounding(Microsoft Bing博客)
- Google, OpenAI, Microsoft, and Anthropic back a shared robots.txt AI training signal(Coywolf)