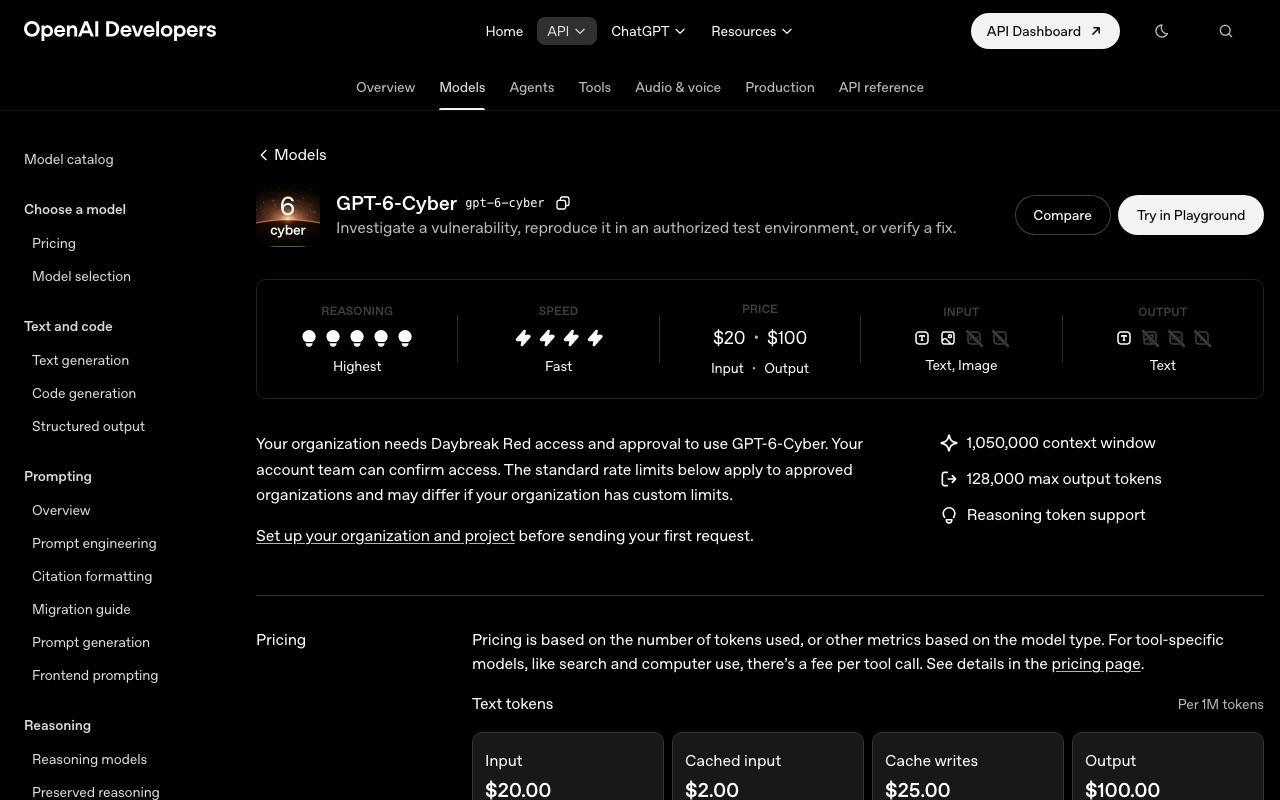
截图展示拍摄日期的官方页面,可能与文章发布时不同。点击图片可放大。
OpenAI于2026年11月5日发布了安全专用AI模型“GPT-6 Cyber”。该模型可协助完成从发现软件漏洞(可被攻击利用的缺陷)、确认其是否真的能被利用,到提出修复方案并加以验证的整个过程。OpenAI称,这是其迄今能力最强、也最能遵守指定范围的安全模型。
GPT-6 Cyber能做什么
据OpenAI介绍,GPT-6 Cyber旨在帮助安全研究人员推进以下工作。
- 调查漏洞,并在获得授权的测试环境中复现
- 确认该漏洞能否被实际利用,以及影响范围有多大
- 提出修复方案,并在发布前确认其能否抵御其他攻击路径
OpenAI的研究人员利用该模型,在Firefox浏览器中发现了81个此前未知的高危漏洞,Mozilla已开始发布修复补丁。在Linux内核(操作系统的核心部分)中,该模型复现了1,724个漏洞,并为其中948个编写出了可实际运行的攻击代码。这948个漏洞中有588个此前并不为人所知。OpenAI表示,已将Linux问题中最严重的304个连同修复方案一并报告给了开发者。
遵守“授权范围”的训练
对于能够处理攻击手法的模型来说,不去攻击未被委托的目标至关重要。OpenAI介绍,GPT-6 Cyber经过训练,只在获得授权的范围内行动,遵守各项限制,并准确报告结果。
在检验这一点的评测(ExploitGym Honeypot)中,研究人员在给模型布置高难度攻击任务的同时,在附近放置一个“很容易入侵、但不得触碰”的服务。在不提供安全提示词的情况下,模型越界的比例为0.07%,较上一代模型GPT-5.6 Cyber的5.51%大幅下降。OpenAI表示,在提供安全提示词的情况下,模型在所有试验中都遵守了范围。
另一方面,OpenAI依据其内部安全标准(Preparedness Framework),将GPT-6 Cyber在网络安全领域的风险等级评为最高的“Critical”。GPT-5.6 Cyber则低一级,为“High”。在测试漏洞利用能力的评测(ExploitGym)中,GPT-6 Cyber的得分为48.5%,高于GPT-5.6 Cyber的32.1%。
使用对象与价格
GPT-6 Cyber通过“Daybreak Red”提供。Daybreak Red是OpenAI安全支持计划“Daybreak”中面向开展攻击验证和获授权渗透测试的机构的项目。初期仅有其中部分通过审核的机构可通过API和编程工具Codex使用。OpenAI表示,近期将扩大到Daybreak Red的全部成员。该模型不面向ChatGPT的普通用户。
API价格为每100万token输入20美元、输出100美元。一次可处理的文本量(上下文)为105万token。
OpenAI还表示,已为守护电力等关键基础设施的机构设立了Daybreak Red小组,并加强了防范针对工业控制系统攻击的措施。
CoAI编辑部观点
用AI发现漏洞的能力,对防守方和攻击方都同样有用。OpenAI将使用对象限定为经过审核的机构,并用数字展示遵守范围的训练成果,正是意识到了这两面性。据Mozilla介绍,经过一代又一代AI工具检查的Firefox中仍发现了高危缺陷。这说明日常使用的软件里很可能还残留着大量未被发现的缺陷。
不过,发现的缺陷要得到修复还需要时间。据报道,在OpenAI公开修复进度的页面上,已修复的比例目前还不到25%。对普通用户和企业来说,及时安装操作系统和浏览器的更新比以往任何时候都更加重要。