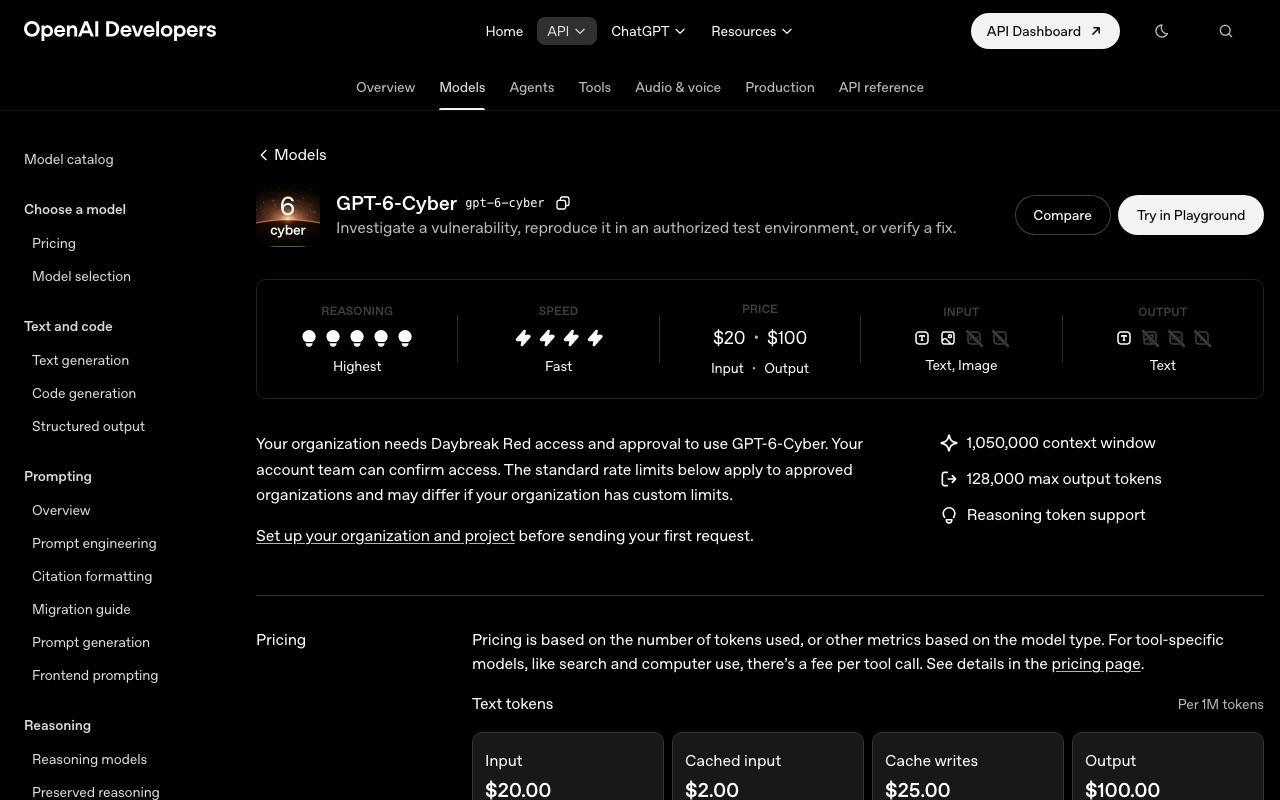
截圖顯示拍攝日期的官方頁面,可能與文章發布時不同。點選圖片可放大。
OpenAI於2026年11月5日推出資安專用AI模型「GPT-6 Cyber」。這款模型能協助完成從找出軟體漏洞(可被攻擊利用的缺陷)、確認是否真的能被利用,到提出修補方案並加以驗證的整個流程。OpenAI表示,這是該公司至今能力最強、也最能遵守指定範圍的資安模型。
GPT-6 Cyber能做什麼
根據OpenAI的說明,GPT-6 Cyber是為了協助資安研究人員進行以下工作而設計的模型。
- 調查漏洞,並在獲得授權的測試環境中重現
- 確認該漏洞能否被實際利用,以及影響範圍有多大
- 提出修補方案,並在發布前確認能否抵擋其他攻擊途徑
OpenAI的研究人員運用這款模型,在Firefox瀏覽器中找到81個過去未知的高風險漏洞,Mozilla已開始發布修補程式。在Linux核心(作業系統的核心部分)方面,模型重現了1,724個漏洞,並為其中948個寫出能實際運作的攻擊程式碼。這948個漏洞中,有588個過去並不為人所知。OpenAI表示,已將Linux問題中最嚴重的304個連同修補方案一併回報給開發者。
遵守「授權範圍」的訓練
對能夠處理攻擊手法的模型來說,不去攻擊未經委託的對象至關重要。OpenAI說明,GPT-6 Cyber經過訓練,只在獲得授權的範圍內行動、遵守各項限制,並正確回報結果。
在檢驗這一點的評測(ExploitGym Honeypot)中,研究人員會給模型高難度的攻擊任務,同時在旁邊放置一個「很容易入侵、但不准碰」的服務。在沒有提供安全提示詞的情況下,模型越界的比例為0.07%,比上一代模型GPT-5.6 Cyber的5.51%大幅下降。OpenAI表示,在提供安全提示詞的情況下,模型在所有試驗中都遵守了範圍。
另一方面,OpenAI依據內部的安全標準(Preparedness Framework),將GPT-6 Cyber在網路安全領域的風險等級評為最高的「Critical」。GPT-5.6 Cyber則低一級,為「High」。在測試漏洞攻擊能力的評測(ExploitGym)中,GPT-6 Cyber的成績為48.5%,高於GPT-5.6 Cyber的32.1%。
使用對象與價格
GPT-6 Cyber透過「Daybreak Red」提供。Daybreak Red是OpenAI資安支援計畫「Daybreak」中,針對進行攻擊驗證與獲授權滲透測試的機構所設的方案。初期僅限其中部分通過審核的機構,透過API與程式開發工具Codex使用。OpenAI表示,近期將擴大到Daybreak Red的所有成員。這款模型並不開放給ChatGPT的一般使用者。
API價格為每100萬token輸入20美元、輸出100美元。一次可處理的文字量(上下文)為105萬token。
OpenAI也表示,已為守護電力等關鍵基礎設施的機構成立Daybreak Red群組,並強化了防範工業控制系統遭受攻擊的對策。
CoAI編輯部觀點
用AI找出漏洞的能力,對防守方與攻擊方都同樣有用。OpenAI將使用對象限定為通過審核的機構,並以數字呈現遵守範圍的訓練成果,正是意識到這種兩面性。根據Mozilla的說法,經過一代又一代AI工具檢查的Firefox,仍被找出了高風險缺陷。這顯示日常使用的軟體裡很可能還藏著許多尚未發現的缺陷。
不過,找到的缺陷要修補完成仍需要時間。根據報導,在OpenAI公開修補進度的頁面上,已修補的比例目前還不到25%。對一般使用者與企業來說,隨時套用作業系統與瀏覽器的更新,比以往更加重要。