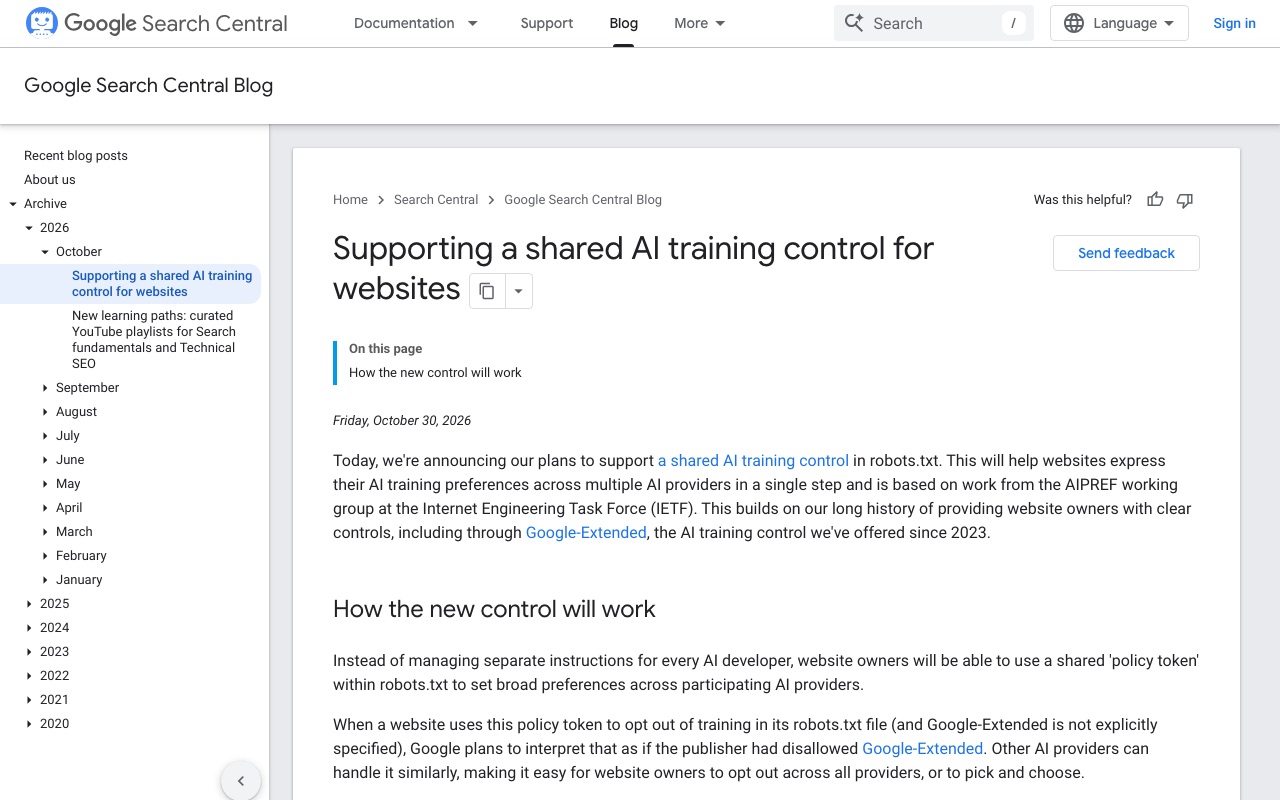
Las capturas muestran las páginas oficiales en la fecha indicada y pueden diferir de las de la publicación. Selecciona una imagen para ampliarla.
El 30 de octubre de 2026 (hora de EE. UU.), OpenAI, Google, Microsoft y Anthropic anunciaron que darán soporte a un mecanismo que permite a los operadores de sitios web indicar, con una forma común de escribir robots.txt, si quieren o no que el contenido de su sitio se use para entrenar IA generativa. Hasta ahora, para rechazar el entrenamiento de IA había que escribir uno por uno los nombres de cada empresa, como GPTBot o Google-Extended; a partir de ahora, una sola entrada bastará para comunicar la preferencia a todas las empresas que lo admitan.
Cómo funciona: escribir "__usage_ai-training" en robots.txt
La base es un documento titulado "Machine-Readable Training Preference Signal", que Kevin Kelley, de Anthropic, presentó ese mismo día ante la IETF (el organismo donde se debaten los estándares técnicos de internet). En la línea "User-Agent" de robots.txt, donde normalmente se escribe el nombre de un rastreador, se coloca el token común "__usage_ai-training", y debajo se indica con Disallow (rechazar) y Allow (permitir), ruta por ruta, si el contenido puede usarse para entrenamiento.
El ejemplo que aparece en el documento es el siguiente.
- User-Agent: __usage_ai-training
- Disallow: /
- Allow: /press-kit/
En este caso, el sitio expresa que no quiere que nada de su contenido se use para entrenamiento, salvo lo que está bajo /press-kit/, que sí puede usarse.
El documento también establece los siguientes puntos.
- "User-Agent: *" (la indicación dirigida a todos los rastreadores) no se aplica a este token. Para rechazar el entrenamiento, hay que escribir este token de forma explícita
- Aquí, entrenamiento significa usar el contenido para modificar los parámetros de un modelo de IA generativa. Los modelos que solo se usan para clasificar u ordenar quedan fuera
- No se añaden nuevas directivas ni nueva sintaxis; se usa la forma de escribir robots.txt que ya existe
- El significado de las entradas que indican el nombre del rastreador de cada empresa, como GPTBot, no cambia
Cabe señalar que este documento no es un estándar oficial de la IETF, sino una propuesta presentada a título individual.
Lo que hará cada empresa
Las cuatro empresas anunciaron que darán soporte al token común, y aclararon que los ajustes propios de cada una seguirán funcionando. Sin embargo, los plazos y la forma de aplicarlo varían según la empresa.
- Anthropic: es la empresa que presentó el documento y, según se informa, ya ha empezado a darle soporte
- OpenAI: le dará soporte en los próximos meses. Afirma que no sustituye a los ajustes actuales
- Microsoft (Bing): a partir del 1 de febrero de 2027, tendrá en cuenta esta indicación al rastrear
- Google: apunta a darle soporte en 2027
La explicación de Google tiene un punto que conviene tener en cuenta. Si un sitio rechaza el entrenamiento con el token común y no dice nada sobre Google-Extended, Google tiene previsto tratar Google-Extended como rechazado también. Google-Extended afecta no solo al entrenamiento de los modelos Gemini, sino también a si el contenido se usa como fundamento de las respuestas en la app Gemini. Google indica que los sitios que permitan Google-Extended de forma explícita seguirán apareciendo como fundamento de las respuestas en la app Gemini y podrán recibir clics.
Bing también añade un ajuste para rechazar el uso como "fundamento de las respuestas"
Ese mismo día, Microsoft anunció además un ajuste, separado del de entrenamiento, que permite elegir si una página puede usarse como fundamento (grounding) de las respuestas de IA en Bing, Copilot y otros servicios.
- Entrenamiento: además del token común de robots.txt, también se puede indicar página por página con una etiqueta meta (por ejemplo, <meta name="Bingbot" content="ai-training:disallow">) o con un encabezado HTTP. La indicación por página tiene prioridad sobre la de robots.txt
- Fundamento de las respuestas: página por página, se puede elegir "disallow", que lo rechaza todo, o "disallowextended", que solo rechaza el uso fuera de los productos de la propia Microsoft
Microsoft afirma que estos ajustes no cambian si una página puede aparecer o no en los resultados de búsqueda normales de Bing. Por otro lado, explica que rechazar el uso como fundamento de las respuestas hace que la página tenga menos probabilidades de aparecer en las respuestas generadas por la IA. Además, a partir del 1 de marzo de 2027 dejará de leer "NoArchive" y "NoCache", que hasta ahora trataba como indicaciones relacionadas con la IA, para ese fin. Para la transición, a partir del 15 de diciembre de 2026, solo los sitios que en ese momento usen NoArchive o NoCache podrán configurar en Bing Webmaster Tools preferencias temporales sobre el uso como fundamento de las respuestas.
El punto de vista de CoAI
Hasta ahora, los sitios que querían rechazar el entrenamiento de IA tenían que añadir un nombre nuevo a robots.txt cada vez que aparecía un rastreador nuevo. Que las cuatro grandes empresas adopten la misma forma de escribirlo reduce mucho ese trabajo. También es un avance para los operadores de sitios que se extiendan ajustes que permiten tratar por separado el entrenamiento de IA generativa y el uso como fundamento de las respuestas de IA.
Sin embargo, no todo cambiará de inmediato. Google y Microsoft empezarán en 2027, y OpenAI solo ha dicho "en los próximos meses", sin indicar una fecha concreta. Además, este mecanismo solo sirve para comunicar una preferencia: no tiene fuerza para obligar a cumplirla a las empresas que no lo admitan. En el caso de Google, hay que tener cuidado: aunque la intención sea rechazar solo el entrenamiento, si no se permite Google-Extended, el contenido dejará de usarse en las respuestas de la app Gemini. Por ahora, lo más seguro es mantener también las entradas existentes de cada empresa.
Fuentes
- Machine-Readable Training Preference Signal (IETF Datatracker)
- Making it easier for websites to express AI training preferences (OpenAI)
- Supporting a shared AI training control for websites (Google Search Central Blog)
- Your content, your choice: clearer preferences for training and grounding (Microsoft Bing Blogs)
- Google, OpenAI, Microsoft, and Anthropic back a shared robots.txt AI training signal (Coywolf)
Herramientas mencionadas en este artículo
 ChatGPTLa IA conversacional de OpenAI para resolver dudas, redactar, resumir, programar y desarrollar ideas.Ver detalles
 GeminiLa IA conversacional de Google, que se integra con la Búsqueda de Google y Workspace.Ver detalles
 ClaudeUn asistente de IA conversacional de Anthropic destacado por su comprensión de textos largos y su generación de texto natural.Ver detalles
 Microsoft CopilotMicrosoft Copilot es un servicio de asistente de IA de propósito general que se puede usar para responder preguntas y realizar búsquedas.Ver detalles