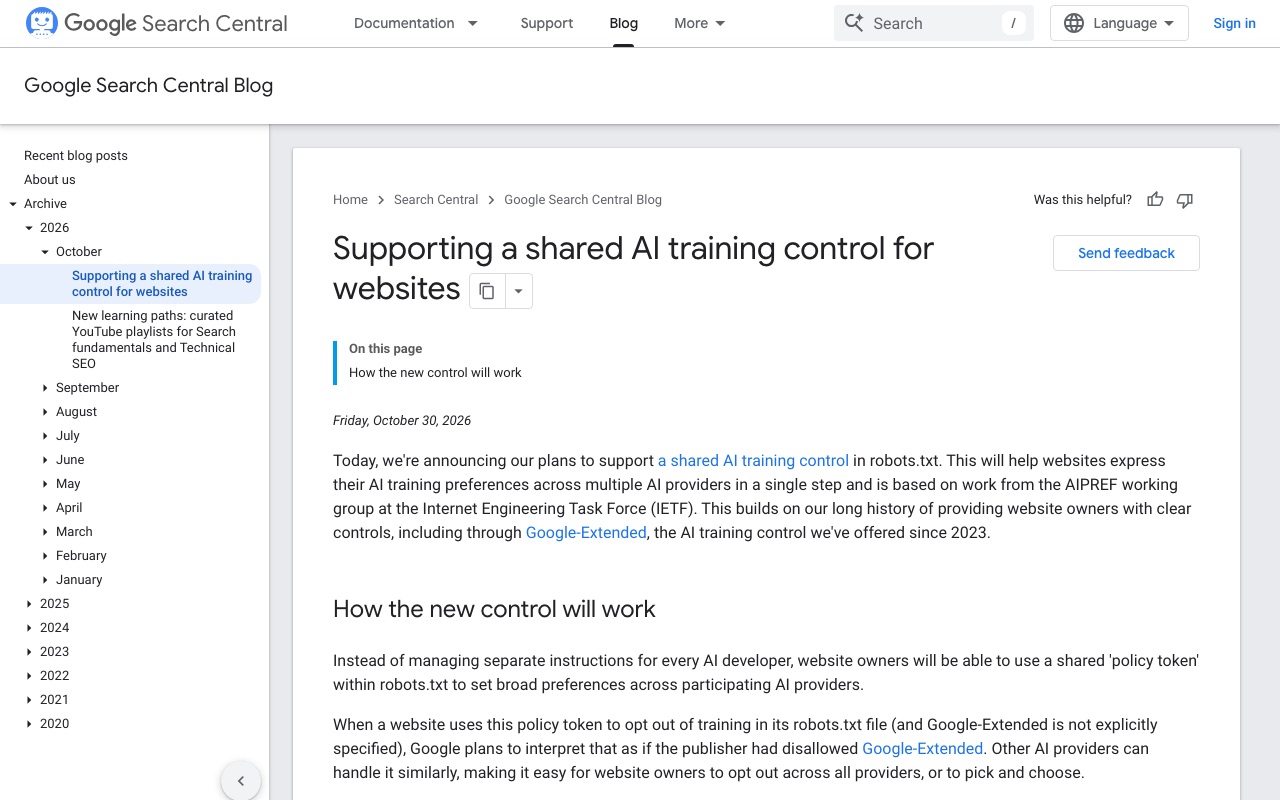
Tangkapan layar menampilkan halaman resmi pada tanggal pengambilan dan mungkin berbeda dari saat artikel diterbitkan. Pilih gambar untuk memperbesar.
OpenAI, Google, Microsoft, dan Anthropic mengumumkan pada 30 Oktober 2026 (waktu AS) bahwa mereka akan mendukung mekanisme yang memungkinkan pengelola situs web menyampaikan, dengan cara penulisan bersama di robots.txt, apakah mereka mengizinkan konten situsnya dipakai untuk melatih AI generatif. Selama ini, untuk menolak pelatihan AI, pengelola situs harus menuliskan nama khusus tiap perusahaan satu per satu, seperti GPTBot atau Google-Extended. Kini, cukup satu entri untuk menyampaikan preferensi tersebut sekaligus kepada perusahaan-perusahaan yang mendukungnya.
Cara kerjanya: tulis "__usage_ai-training" di robots.txt
Dasarnya adalah dokumen "Machine-Readable Training Preference Signal" yang diajukan Kevin Kelley dari Anthropic pada hari yang sama ke IETF (organisasi yang membahas standar teknis internet). Pada baris "User-Agent" di robots.txt, yang biasanya berisi nama crawler, dituliskan token bersama "__usage_ai-training", lalu di bawahnya Disallow (tolak) dan Allow (izinkan) menunjukkan per path apakah konten boleh dipakai untuk pelatihan.
Contoh yang tercantum dalam dokumen tersebut adalah sebagai berikut.
- User-Agent: __usage_ai-training
- Disallow: /
- Allow: /press-kit/
Dalam contoh ini, situs menyatakan tidak ingin seluruh kontennya dipakai untuk pelatihan, kecuali bagian di bawah /press-kit/ yang boleh dipakai.
Dokumen tersebut juga menetapkan hal-hal berikut.
- "User-Agent: *" (pengaturan untuk semua crawler) tidak berlaku untuk token ini. Untuk menolak pelatihan, token ini harus ditulis secara eksplisit
- Yang dimaksud pelatihan di sini adalah penggunaan untuk mengubah parameter model AI generatif. Model yang hanya dipakai untuk klasifikasi atau pemeringkatan tidak termasuk
- Tidak ada perintah atau sintaks baru; cara penulisan robots.txt yang sudah ada dipakai apa adanya
- Arti entri yang menyebut nama crawler tiap perusahaan, seperti GPTBot, tidak berubah
Perlu dicatat, dokumen ini bukan standar resmi IETF, melainkan masih berupa usulan individu.
Dukungan tiap perusahaan
Keempat perusahaan menyatakan akan mendukung token bersama ini, sambil menegaskan bahwa pengaturan khusus tiap perusahaan yang sudah ada tetap bisa digunakan. Namun, waktu dan cara penanganannya berbeda-beda.
- Anthropic: perusahaan yang mengajukan dokumen tersebut, dan dilaporkan sudah mulai mendukungnya
- OpenAI: akan mendukung dalam beberapa bulan ke depan. Disebutkan bahwa ini tidak menggantikan pengaturan yang sudah ada
- Microsoft (Bing): mulai 1 Februari 2027 akan menerapkan pengaturan ini saat crawling
- Google: menargetkan dukungan pada 2027
Ada hal yang perlu diperhatikan dalam penjelasan Google. Jika sebuah situs menolak pelatihan dengan token bersama dan tidak menulis apa pun tentang Google-Extended, Google berencana memperlakukan Google-Extended juga sebagai ditolak. Google-Extended tidak hanya terkait pelatihan model Gemini, tetapi juga apakah konten dipakai sebagai dasar jawaban di aplikasi Gemini. Google menyatakan bahwa situs yang secara eksplisit mengizinkan Google-Extended akan tetap ditampilkan sebagai dasar jawaban di aplikasi Gemini dan tetap bisa diklik.
Bing juga menambahkan pengaturan untuk menolak penggunaan sebagai "dasar jawaban"
Pada hari yang sama, Microsoft juga mengumumkan pengaturan terpisah dari pelatihan, yang memungkinkan situs memilih apakah halamannya boleh dipakai sebagai dasar jawaban AI (grounding) di Bing, Copilot, dan lainnya.
- Pelatihan: selain token bersama di robots.txt, dapat juga ditentukan per halaman dengan tag meta (contoh: <meta name="Bingbot" content="ai-training:disallow">) atau header HTTP. Pengaturan per halaman lebih diutamakan daripada pengaturan di robots.txt
- Dasar jawaban: per halaman dapat dipilih "disallow" yang menolak semuanya, atau "disallowextended" yang hanya menolak penggunaan di luar produk Microsoft sendiri
Microsoft menyatakan pengaturan ini tidak mengubah apakah halaman memenuhi syarat untuk ditampilkan di hasil pencarian biasa Bing. Di sisi lain, Microsoft menjelaskan bahwa jika penggunaan sebagai dasar jawaban ditolak, halaman akan lebih jarang muncul di jawaban yang dibuat AI. Selain itu, "NoArchive" dan "NoCache", yang selama ini diperlakukan sebagai pernyataan preferensi terkait AI, tidak lagi dibaca untuk tujuan tersebut mulai 1 Maret 2027. Sebagai masa transisi, mulai 15 Desember 2026, hanya situs yang saat itu menggunakan NoArchive atau NoCache yang dapat mengatur preferensi sementara terkait dasar jawaban di Bing Webmaster Tools.
Pandangan Redaksi CoAI
Selama ini, situs yang ingin menolak pelatihan AI harus menambahkan nama ke robots.txt setiap kali muncul crawler baru. Dengan empat perusahaan besar mendukung cara penulisan yang sama, repot itu akan jauh berkurang. Meluasnya pengaturan yang memisahkan pelatihan AI generatif dari penggunaan sebagai dasar jawaban AI juga merupakan kemajuan bagi pengelola situs.
Namun, semuanya tidak akan langsung berubah. Dukungan Google dan Microsoft baru dimulai pada 2027, dan OpenAI pun hanya menyebut "dalam beberapa bulan ke depan" tanpa memberikan tanggal yang pasti. Mekanisme ini juga hanya menyampaikan preferensi, tanpa daya paksa terhadap perusahaan yang tidak mendukungnya. Untuk Google, perhatikan bahwa meskipun Anda bermaksud hanya menolak pelatihan, konten Anda tidak akan lagi dipakai dalam jawaban aplikasi Gemini jika Google-Extended tidak diizinkan. Untuk sementara, lebih aman tetap mempertahankan entri khusus tiap perusahaan yang sudah ada.
Sumber
- Machine-Readable Training Preference Signal (IETF Datatracker)
- Making it easier for websites to express AI training preferences (OpenAI)
- Supporting a shared AI training control for websites (Google Search Central Blog)
- Your content, your choice: clearer preferences for training and grounding (Microsoft Bing Blogs)
- Google, OpenAI, Microsoft, and Anthropic back a shared robots.txt AI training signal (Coywolf)
Alat yang disebutkan dalam artikel ini
 ChatGPTAI percakapan dari OpenAI untuk menjawab pertanyaan, menulis, merangkum, membuat kode, dan mengembangkan ide.Lihat detail
 GeminiAI percakapan dari Google yang dapat terintegrasi dengan Google Search dan Workspace.Lihat detail
 ClaudeAsisten AI percakapan dari Anthropic yang unggul dalam memahami teks panjang dan menghasilkan tulisan yang alami.Lihat detail
 Microsoft CopilotMicrosoft Copilot adalah layanan AI untuk asisten AI serbaguna yang dapat dimanfaatkan untuk tanya jawab dan pencarian.Lihat detail