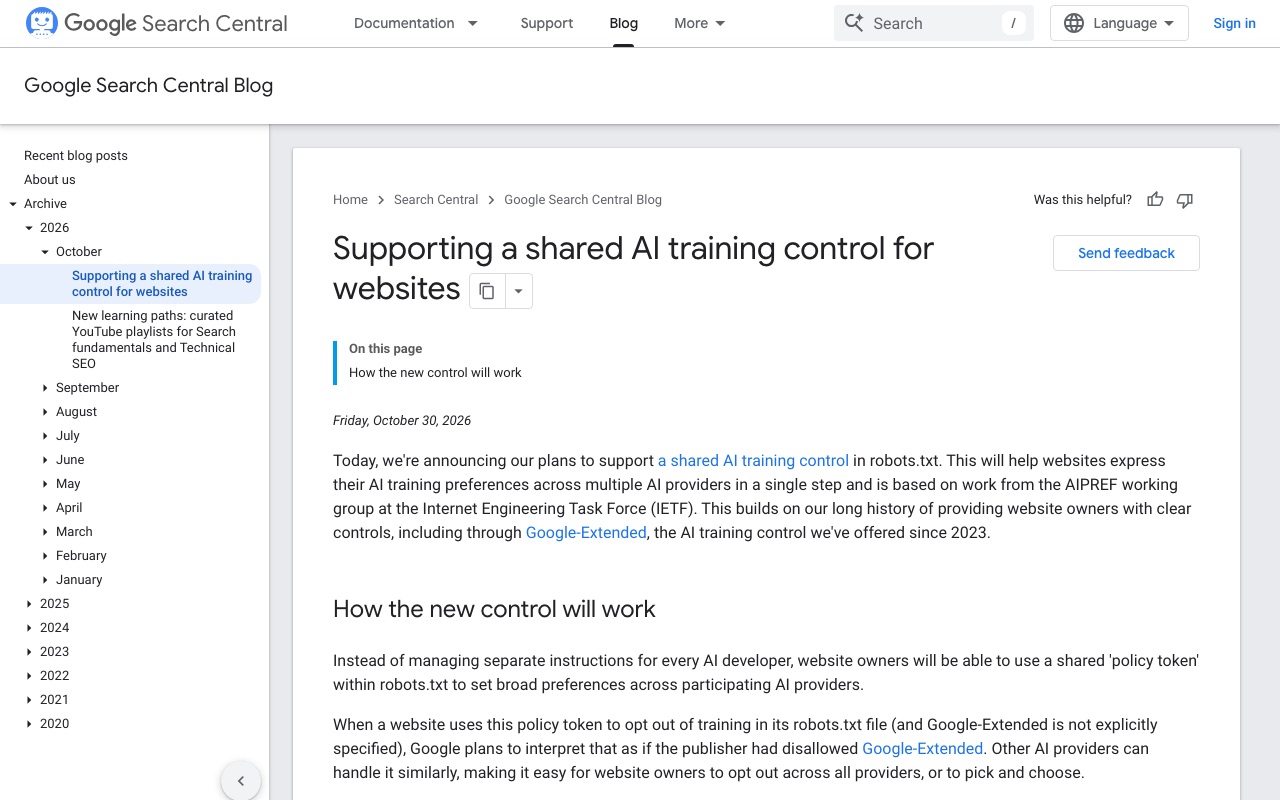
画面は撮影時点の公式ページです。記事公開時の画面とは異なる場合があります。画像を選択すると拡大表示できます。
OpenAI、Google、Microsoft、Anthropicの4社は2026年10月30日(米国時間)、ウェブサイトの運営者が、自分のサイトの内容を生成AIの学習に使ってほしいかどうかを、robots.txtの共通の書き方で伝えられる仕組みに対応すると発表しました。これまでは、AIの学習を断るにはGPTBotやGoogle-Extendedなど会社ごとの名前を1つずつ書く必要がありましたが、対応する会社には1か所の記述でまとめて意思を伝えられるようになります。
仕組み:robots.txtに「__usage_ai-training」を書く
土台になっているのは、AnthropicのKevin Kelley氏が同じ日にIETF(インターネットの技術標準を議論する団体)へ提出した文書「Machine-Readable Training Preference Signal」です。robots.txtで通常はクローラーの名前を書く「User-Agent」の行に、共通のトークン「__usage_ai-training」を書き、その下のDisallow(拒否)とAllow(許可)で、学習に使ってよいかどうかをパスごとに示します。
文書に載っている例は次のとおりです。
- User-Agent: __usage_ai-training
- Disallow: /
- Allow: /press-kit/
この場合、サイト全体について学習に使ってほしくないという意思を示し、/press-kit/ 以下だけは学習に使ってよいとしています。
文書では、次の点も定めています。
- 「User-Agent: *」(すべてのクローラー向けの指定)は、このトークンには当てはまらない。学習を断るには、このトークンを明記する必要がある
- ここでいう学習は、生成AIモデルのパラメータを変えるために使うこと。分類や順位付けだけに使うモデルは対象外
- 新しい命令や文法は加えず、既存のrobots.txtの書き方をそのまま使う
- GPTBotなど、各社のクローラー名を指定した記述の意味は変わらない
なお、この文書はIETFの正式な標準ではなく、個人の提案として出された段階のものです。
各社の対応
4社とも、既存の会社ごとの設定は今後も使えるとしたうえで、共通のトークンに対応すると表明しました。ただし、対応の時期と扱い方は会社によって違います。
- Anthropic:文書を提出した会社で、すでに対応を始めていると報じられている
- OpenAI:今後数か月のうちに対応する。今ある設定に置き換わるものではないとしている
- Microsoft(Bing):2027年2月1日から、クロールの際にこの指定を反映する
- Google:2027年の対応を目指す
Googleの説明には、注意が必要な点があります。サイトが共通のトークンで学習を断り、Google-Extendedについて何も書いていない場合、GoogleはGoogle-Extendedも拒否されたものとして扱う予定です。Google-Extendedは、Geminiのモデルの学習のほか、Geminiアプリで回答の根拠として使われるかどうかにも関わります。Googleは、Google-Extendedを明示的に許可したサイトは、引き続きGeminiアプリの回答の根拠として表示され、クリックされる対象になるとしています。
Bingは「回答の根拠」を断る設定も追加
Microsoftは同じ日に、学習とは別に、BingやCopilotなどのAIの回答の根拠(グラウンディング)としてページを使われるかどうかを選べる設定も発表しました。
- 学習:robots.txtの共通トークンに加え、ページごとにmetaタグ(例:<meta name="Bingbot" content="ai-training:disallow">)やHTTPヘッダーでも指定できる。ページごとの指定はrobots.txtの指定より優先される
- 回答の根拠:ページごとに、すべて拒否する「disallow」か、Microsoft自身の製品以外での利用だけを断る「disallowextended」を選べる
Microsoftは、これらの設定によってBingの通常の検索結果に掲載される対象かどうかは変わらないとしています。一方で、回答の根拠としての利用を断ると、AIが作る回答の中でページが表示されにくくなると説明しています。また、これまでAIに関する意思表示として扱ってきた「NoArchive」と「NoCache」は、2027年3月1日以降はその目的では読まなくなります。その移行のため、2026年12月15日から、その時点でNoArchiveやNoCacheを使っているサイトに限り、Bing Webmaster Toolsで回答の根拠に関する一時的な設定ができるようになります。
CoAI編集部の視点
これまでAIの学習を断りたいサイトは、新しいクローラーが出るたびにrobots.txtへ名前を書き足す必要がありました。主要な4社が同じ書き方に対応することで、その手間は大きく減ります。生成AIの学習と、AIの回答の根拠としての利用を分けて考えられる設定が広がるのも、サイト運営者にとっては前進です。
ただし、すぐにすべてが切り替わるわけではありません。GoogleとMicrosoftの対応は2027年からで、OpenAIも「今後数か月のうち」として具体的な日付は示していません。また、この仕組みはあくまで意思を伝えるもので、対応していない会社に守らせる強制力はありません。Googleについては、学習だけを断ったつもりでも、Google-Extendedを許可しておかないとGeminiアプリの回答に使われなくなる点に気をつけましょう。当面は、既存の会社ごとの記述も残しておくのが安全です。
出典
- Machine-Readable Training Preference Signal(IETF Datatracker)
- Making it easier for websites to express AI training preferences(OpenAI)
- Supporting a shared AI training control for websites(Google Search Central Blog)
- Your content, your choice: clearer preferences for training and grounding(Microsoft Bing Blogs)
- Google, OpenAI, Microsoft, and Anthropic back a shared robots.txt AI training signal(Coywolf)