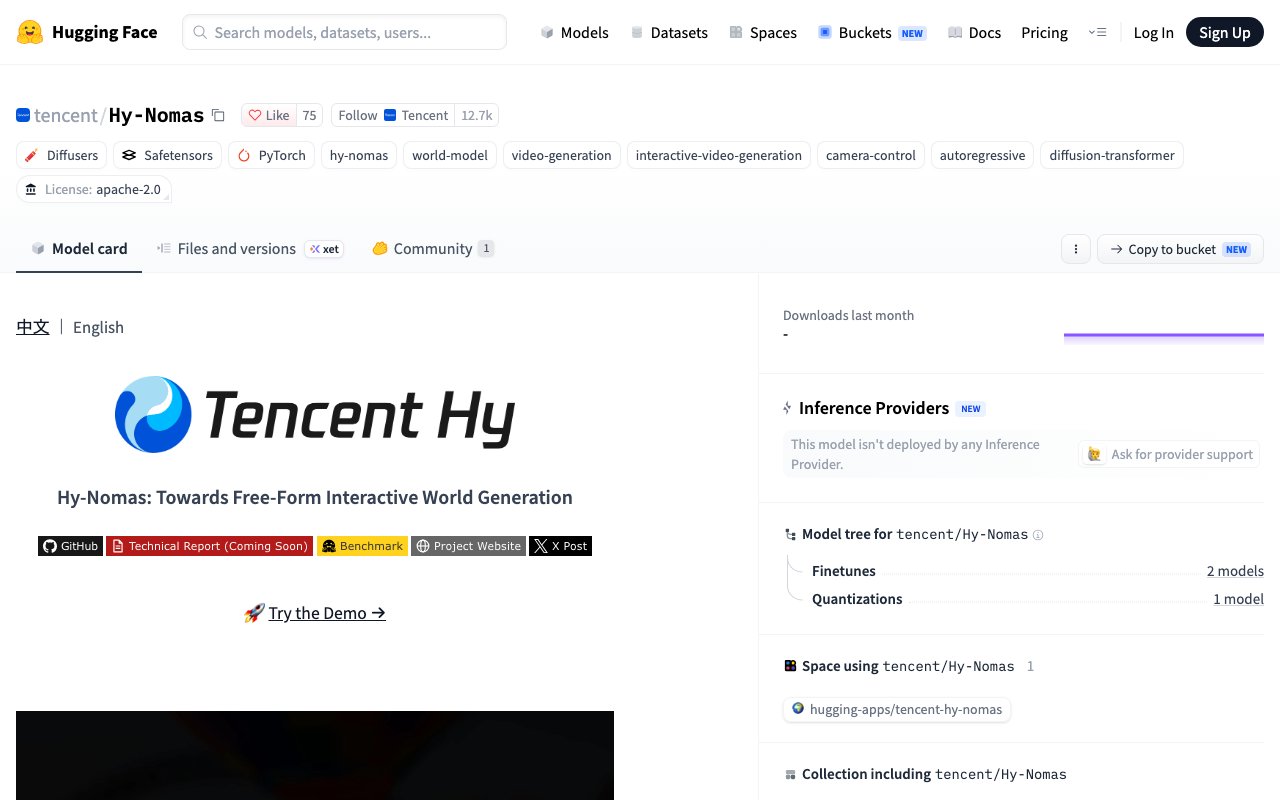
画面は撮影時点の公式ページです。記事公開時の画面とは異なる場合があります。画像を選択すると拡大表示できます。
Tencent(テンセント)の混元(Hunyuan)チームは2026年10月24日(中国時間・日本時間)、動画の「世界」を作り続けるAIモデル「Hy-Nomas」を公式Xで告知しました。文章の指示とカメラの動きを組み合わせて、場面を区切りごとに生成し、途中で物を足したり、画風や動きを変えたりできます。モデルの重みとコードはHugging FaceとGitHubで公開されており、ライセンスは商用でも使いやすいApache-2.0です。
Hy-Nomasとは
Hy-Nomasは、Tencentが「対話型の動画世界生成モデル」と呼ぶAIです。ふつうの動画生成AIは、1つの指示から決まった長さの動画を作ります。Hy-Nomasは、動画を短い区切り(セグメント)ごとに作り、そのたびに新しい指示を受け付けます。
モデルカードによると、生成の途中で次のような操作ができます。
- 文章で、物を加える、画風や場面を変える、登場するものに動きを指示する
- カメラの動きを指定して、世界の中を移動する
- 文章の指示とカメラの操作を交互に入れる
前の区切りの内容を覚えておく仕組み(世界の記憶)を持ち、場面が続いても見た目や配置の一貫性を保つとしています。
性能と動作環境
公開された高速版のモデルは、8ステップの処理で、縦720×横1280ピクセル、毎秒24コマの動画を出力します。GitHubの説明では、4・6・8ステップの設定に対応しています。
標準の構成は、GPUを8枚使うことを前提にしています。一方で、モデルを軽くする量子化(INT8)や、一部の処理をCPUに任せる設定を組み合わせると、NVIDIAの家庭向けGPU「GeForce RTX 4090」1枚でも動かせる構成を用意しています。ただし、この1枚の構成は動画を作る部分の話で、Webのデモで使う指示文の補強の仕組みには、別に計算資源が必要です。
なお、24コマは再生する動画のコマ数で、作る速さが実時間に追いつくかどうかは示されていません。パラメーター数や最長の動画の長さも、モデルカードには書かれていません。海外の専門メディアのVP Landは、プロジェクトのページの記載として「80億パラメーター、最長60秒」と伝えていますが、CoAIでは一次情報で確認できていません。
一緒に公開されたもの
モデル本体のほかに、次のものも公開されています。
- 映画のような画づくりに向けたLoRA(追加学習用の小さな部品)
- ロボット向けのLoRA(実際の双腕ロボットのデータで学習)
- 学習・推論・デモのコードと、学習データに説明を付ける仕組み
- 評価用のデータ「Hy-Nomas-Bench」(280件)
Tencentは、ロボット向けのLoRAについて、作った世界でロボットの動きを再現する力を高めるためのものだと説明しており、映像の制作だけでなく、ロボットのシミュレーションの用途も想定していることがうかがえます。ブラウザで試せるオンラインのデモも用意されています。
ライセンスと評価
ライセンスはApache-2.0で、コードだけでなくモデルの重みにも適用されます。ただし、同梱する他社の部品(文章を読み取る部分に使うQwenのモデルなど)は、それぞれ元のライセンスに従います。LICENSEには、それ以上の制限は加えないと書かれています。これまでの混元のモデルの一部は、一部の地域を除外したり、利用者数に上限を設けたりする独自のライセンスで公開されてきました。今回は自由度の高い形で公開した点が目を引きます。
一方で、性能の数字は出ていません。評価用のHy-Nomas-Benchは、複数回の文章の指示、カメラの移動、指示とカメラの組み合わせ、場所の記憶の4つを試す内容ですが、スコアや他のモデルとの比較は公開されていません。技術レポートも「近日公開」のままです。
世界モデルの競争
世界モデルは、文章などから、動き回れる仮想の世界を作るAIです。ゲームや映像の制作のほか、ロボットや自動運転のAIを仮想の環境で訓練する用途でも注目されています。
Tencentはこれまでにも世界モデルのHY-Worldシリーズを公開しており、4月のHY-World 2.0は編集できる3Dのデータを作るモデルでした。Hy-Nomasは3Dのデータを作るのではなく、動画を少しずつつなげて世界を広げる方式で、文章の指示を何度でも差し込める点が特徴です。HY-Worldとの性能の比較は示されていません。
CoAI編集部の視点
Hy-Nomasは、動画生成AIを「一度作って終わり」から、「作りながら指示を重ねていく」ものへ広げる試みです。重みとコードがApache-2.0で公開され、家庭向けのGPU 1枚でも動く構成があるため、研究者や開発者が手元で試しやすいのが利点です。
ただし、性能の数字も技術レポートもまだ出ておらず、良し悪しはTencentのデモと説明でしか判断できません。試す場合は、まずオンラインのデモや少ない設定で動作を確かめ、本格的に使うのは、技術レポートや外部の評価が出てからにするのがよいでしょう。