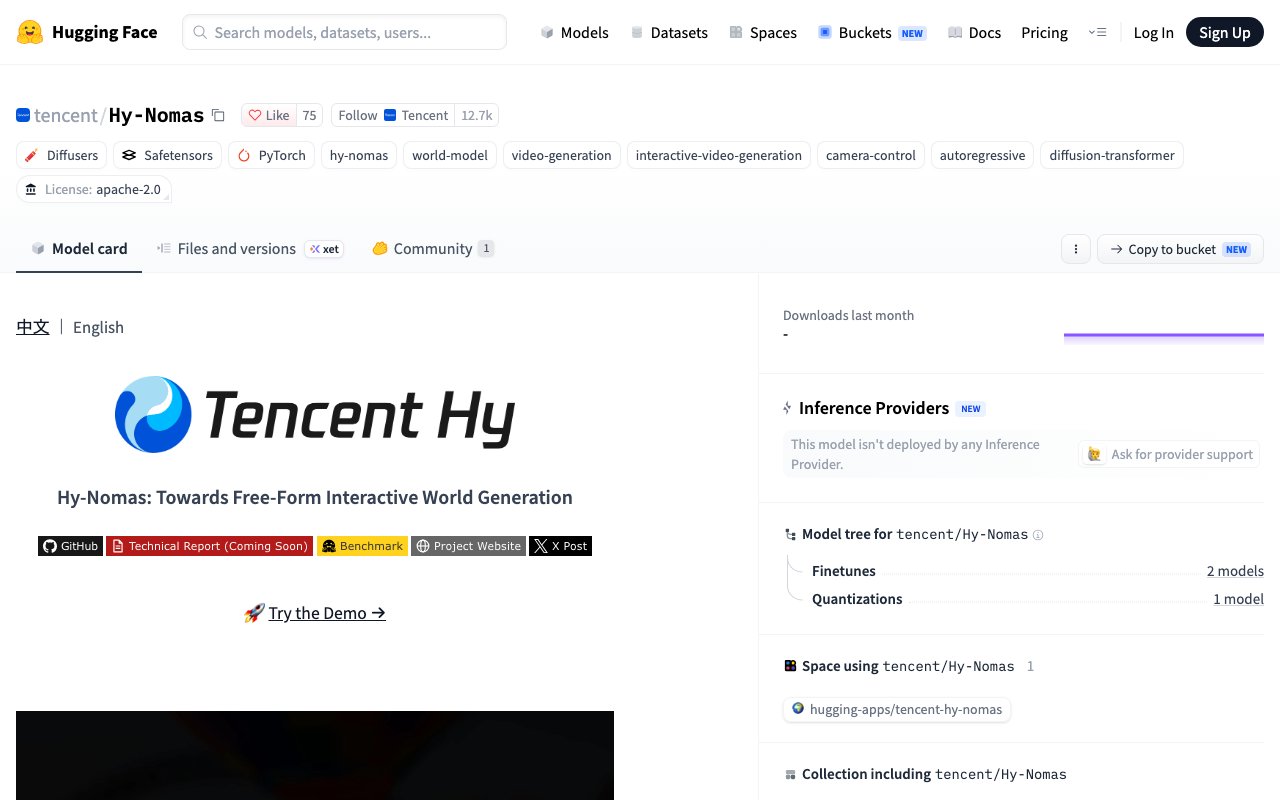
ภาพแสดงหน้าอย่างเป็นทางการ ณ วันที่ถ่าย ซึ่งอาจแตกต่างจากวันที่เผยแพร่บทความ เลือกภาพเพื่อขยาย
ทีม Hunyuan ของ Tencent (เทนเซ็นต์) ประกาศเปิดตัว "Hy-Nomas" ผ่านบัญชี X ทางการเมื่อวันที่ 24 ตุลาคม 2026 (เวลาจีนและเวลาญี่ปุ่น) ซึ่งเป็นโมเดล AI ที่สร้าง "โลก" ในรูปแบบวิดีโออย่างต่อเนื่อง โมเดลนี้ผสานคำสั่งข้อความเข้ากับการเคลื่อนกล้องเพื่อสร้างฉากทีละช่วง และระหว่างทางยังเพิ่มวัตถุ หรือเปลี่ยนสไตล์ภาพและการเคลื่อนไหวได้ น้ำหนักโมเดลและโค้ดเผยแพร่บน Hugging Face และ GitHub ภายใต้สัญญาอนุญาต Apache-2.0 ที่ใช้งานได้สะดวกแม้ในเชิงพาณิชย์
Hy-Nomas คืออะไร
Hy-Nomas คือ AI ที่ Tencent เรียกว่า "โมเดลสร้างโลกวิดีโอแบบโต้ตอบ" AI สร้างวิดีโอทั่วไปจะสร้างวิดีโอความยาวคงที่จากคำสั่งเดียว แต่ Hy-Nomas สร้างวิดีโอเป็นช่วงสั้น ๆ (เซกเมนต์) และรับคำสั่งใหม่ได้ทุกช่วง
ตาม model card ระหว่างการสร้างสามารถทำสิ่งต่อไปนี้ได้
- ใช้ข้อความเพื่อเพิ่มวัตถุ เปลี่ยนสไตล์ภาพหรือฉาก และสั่งการเคลื่อนไหวให้สิ่งที่ปรากฏในฉาก
- กำหนดการเคลื่อนกล้องเพื่อเคลื่อนที่ไปในโลก
- สลับใส่คำสั่งข้อความกับการควบคุมกล้องได้
โมเดลมีกลไกจดจำเนื้อหาของช่วงก่อนหน้า (ความทรงจำของโลก) และ Tencent ระบุว่าช่วยรักษาความสอดคล้องของรูปลักษณ์และการจัดวางแม้ฉากจะดำเนินต่อไป
ประสิทธิภาพและสภาพแวดล้อมที่ต้องใช้
เวอร์ชันความเร็วสูงที่เผยแพร่สร้างวิดีโอขนาดสูง 720 × กว้าง 1280 พิกเซล ที่ 24 เฟรมต่อวินาที ด้วยการประมวลผล 8 ขั้นตอน ตามคำอธิบายใน GitHub รองรับการตั้งค่า 4, 6 และ 8 ขั้นตอน
การตั้งค่ามาตรฐานออกแบบมาโดยใช้ GPU 8 ใบ ในทางกลับกัน เมื่อผสานการควอนไทซ์ (INT8) ที่ทำให้โมเดลเบาลง เข้ากับการตั้งค่าที่ให้ CPU รับงานประมวลผลบางส่วน ก็มีการตั้งค่าที่รันได้แม้บน GPU สำหรับผู้ใช้ทั่วไปของ NVIDIA อย่าง "GeForce RTX 4090" เพียงใบเดียว อย่างไรก็ตาม การตั้งค่าแบบใบเดียวนี้หมายถึงเฉพาะส่วนที่สร้างวิดีโอ ส่วนกลไกเสริมคำสั่ง (prompt) ที่ใช้ในเดโมบนเว็บต้องใช้ทรัพยากรประมวลผลแยกต่างหาก
ทั้งนี้ 24 เฟรมคือจำนวนเฟรมของวิดีโอเมื่อเล่น และไม่ได้ระบุว่าความเร็วในการสร้างทันกับเวลาจริงหรือไม่ จำนวนพารามิเตอร์และความยาววิดีโอสูงสุดก็ไม่ได้เขียนไว้ใน model card สื่อเฉพาะทางต่างประเทศอย่าง VP Land รายงานว่า "8 พันล้านพารามิเตอร์ ยาวสุด 60 วินาที" โดยอ้างข้อมูลจากหน้าโปรเจกต์ แต่ CoAI ยังไม่สามารถยืนยันได้จากแหล่งข้อมูลปฐมภูมิ
สิ่งที่เผยแพร่พร้อมกัน
นอกจากตัวโมเดลหลักแล้ว ยังมีการเผยแพร่สิ่งต่อไปนี้ด้วย
- LoRA (ชิ้นส่วนขนาดเล็กสำหรับการฝึกเพิ่มเติม) สำหรับภาพสไตล์ภาพยนตร์
- LoRA สำหรับหุ่นยนต์ (ฝึกด้วยข้อมูลจากหุ่นยนต์สองแขนจริง)
- โค้ดสำหรับการฝึก การอนุมาน และเดโม รวมถึงกลไกสำหรับใส่คำอธิบายให้ข้อมูลฝึก
- ข้อมูลประเมินผล "Hy-Nomas-Bench" (280 รายการ)
Tencent อธิบายว่า LoRA สำหรับหุ่นยนต์มีไว้เพื่อเพิ่มความสามารถในการจำลองการเคลื่อนไหวของหุ่นยนต์ในโลกที่สร้างขึ้น ซึ่งบ่งบอกว่าโมเดลนี้ไม่ได้มุ่งเฉพาะงานผลิตวิดีโอ แต่ยังคาดการณ์การใช้งานด้านการจำลองหุ่นยนต์ด้วย นอกจากนี้ยังมีเดโมออนไลน์ที่ทดลองใช้บนเบราว์เซอร์ได้
สัญญาอนุญาตและการประเมินผล
สัญญาอนุญาตคือ Apache-2.0 ซึ่งครอบคลุมไม่เพียงโค้ด แต่รวมถึงน้ำหนักโมเดลด้วย อย่างไรก็ตาม ชิ้นส่วนของบริษัทอื่นที่รวมมาด้วย (เช่น โมเดล Qwen ที่ใช้ในส่วนอ่านข้อความ) จะเป็นไปตามสัญญาอนุญาตเดิมของแต่ละราย ไฟล์ LICENSE ระบุว่าไม่มีการเพิ่มข้อจำกัดอื่นนอกเหนือจากนั้น ที่ผ่านมาโมเดล Hunyuan บางรุ่นเผยแพร่ด้วยสัญญาอนุญาตเฉพาะที่ยกเว้นบางภูมิภาคหรือจำกัดจำนวนผู้ใช้ ครั้งนี้การเผยแพร่ในรูปแบบที่มีอิสระสูงจึงเป็นจุดที่น่าสนใจ
ในทางกลับกัน ยังไม่มีตัวเลขประสิทธิภาพออกมา Hy-Nomas-Bench ทดสอบ 4 ด้าน ได้แก่ คำสั่งข้อความหลายครั้ง การเคลื่อนกล้อง การผสมคำสั่งกับกล้อง และความทรงจำเกี่ยวกับสถานที่ แต่ยังไม่มีการเผยแพร่คะแนนหรือการเปรียบเทียบกับโมเดลอื่น รายงานทางเทคนิคก็ยังอยู่ในสถานะ "เร็ว ๆ นี้"
การแข่งขันของโมเดลโลก
โมเดลโลกคือ AI ที่สร้างโลกเสมือนซึ่งเคลื่อนที่ไปมาได้จากข้อความและอินพุตอื่น ๆ นอกจากงานสร้างเกมและวิดีโอแล้ว ยังได้รับความสนใจในการใช้ฝึก AI ของหุ่นยนต์และรถยนต์ไร้คนขับในสภาพแวดล้อมเสมือน
Tencent เคยเผยแพร่โมเดลโลกซีรีส์ HY-World มาก่อน โดย HY-World 2.0 ที่เปิดตัวในเดือนเมษายนเป็นโมเดลที่สร้างข้อมูล 3D ที่แก้ไขได้ Hy-Nomas ไม่ได้สร้างข้อมูล 3D แต่ขยายโลกด้วยการต่อวิดีโอทีละน้อย และมีจุดเด่นที่แทรกคำสั่งข้อความได้กี่ครั้งก็ได้ ยังไม่มีการแสดงการเปรียบเทียบประสิทธิภาพกับ HY-World
มุมมองของกองบรรณาธิการ CoAI
Hy-Nomas เป็นความพยายามขยาย AI สร้างวิดีโอจากแบบ "สร้างครั้งเดียวจบ" ไปสู่แบบ "สร้างไปพร้อมกับเพิ่มคำสั่งไปเรื่อย ๆ" เนื่องจากน้ำหนักโมเดลและโค้ดเผยแพร่ภายใต้ Apache-2.0 และมีการตั้งค่าที่รันบน GPU สำหรับผู้ใช้ทั่วไปใบเดียวได้ นักวิจัยและนักพัฒนาจึงทดลองบนเครื่องของตัวเองได้ง่าย
อย่างไรก็ตาม ทั้งตัวเลขประสิทธิภาพและรายงานทางเทคนิคยังไม่ออกมา จึงตัดสินคุณภาพได้จากเดโมและคำอธิบายของ Tencent เท่านั้น หากจะทดลอง ควรเริ่มตรวจสอบการทำงานจากเดโมออนไลน์หรือการตั้งค่าแบบเบาก่อน และรอใช้งานจริงจังหลังจากมีรายงานทางเทคนิคและการประเมินจากภายนอกแล้ว