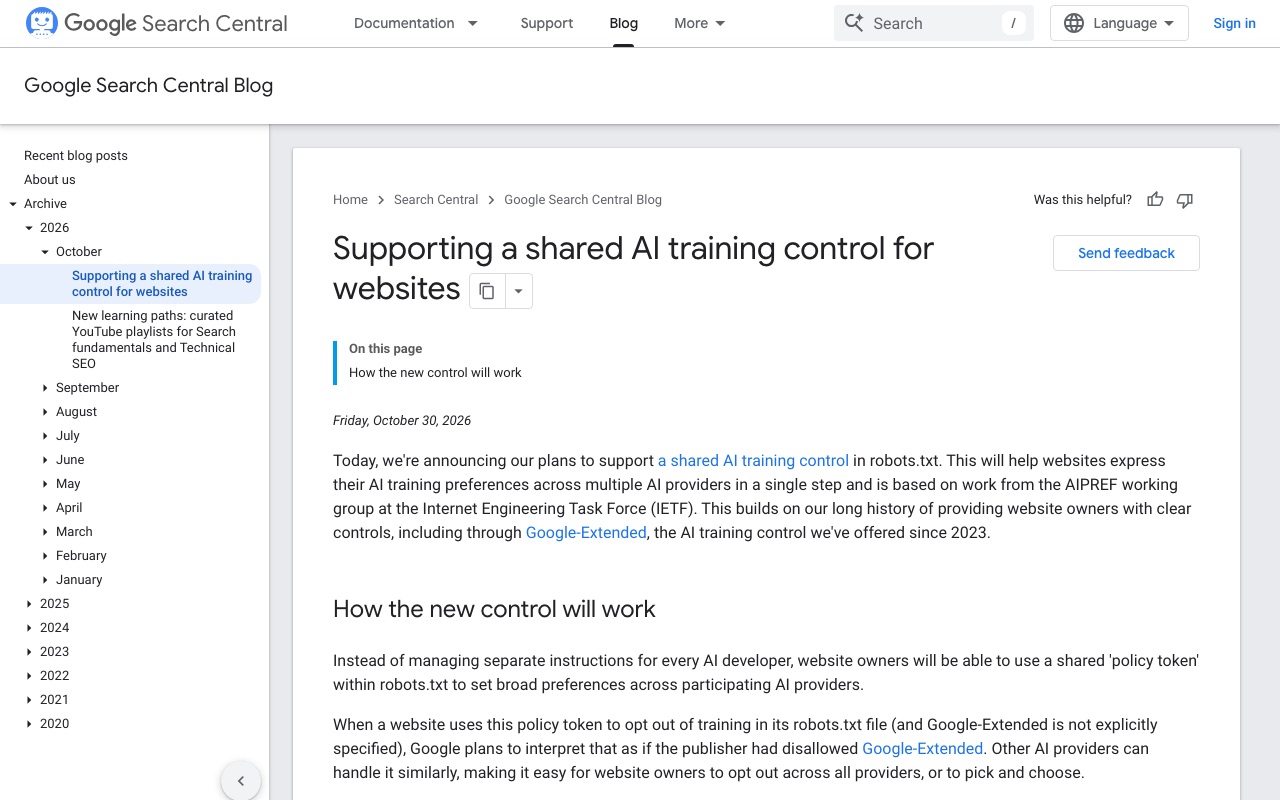
Ảnh chụp hiển thị trang chính thức vào ngày chụp và có thể khác với thời điểm xuất bản bài viết. Chọn ảnh để phóng to.
Ngày 30 tháng 10 năm 2026 (giờ Mỹ), OpenAI, Google, Microsoft và Anthropic thông báo sẽ hỗ trợ cơ chế cho phép người vận hành website cho biết, bằng một cách viết chung trong robots.txt, liệu họ có muốn nội dung trang của mình được dùng để huấn luyện AI tạo sinh hay không. Trước đây, muốn từ chối huấn luyện AI thì phải ghi lần lượt tên riêng của từng công ty như GPTBot hay Google-Extended; giờ đây chỉ cần một khai báo duy nhất là có thể gửi ý muốn đồng loạt tới các công ty hỗ trợ.
Cơ chế: ghi "__usage_ai-training" vào robots.txt
Nền tảng của cơ chế này là tài liệu "Machine-Readable Training Preference Signal" do Kevin Kelley của Anthropic nộp cùng ngày lên IETF (tổ chức thảo luận các tiêu chuẩn kỹ thuật của Internet). Ở dòng "User-Agent" trong robots.txt, nơi thường ghi tên crawler, ta ghi token chung "__usage_ai-training", rồi dùng Disallow (từ chối) và Allow (cho phép) bên dưới để chỉ rõ theo từng đường dẫn liệu nội dung có được dùng để huấn luyện hay không.
Ví dụ trong tài liệu như sau.
- User-Agent: __usage_ai-training
- Disallow: /
- Allow: /press-kit/
Trong trường hợp này, website thể hiện ý muốn không để toàn bộ trang bị dùng để huấn luyện, chỉ riêng phần dưới /press-kit/ là được phép dùng.
Tài liệu cũng quy định các điểm sau.
- "User-Agent: *" (khai báo cho mọi crawler) không áp dụng cho token này. Muốn từ chối huấn luyện thì phải ghi rõ token này
- Huấn luyện ở đây là việc dùng nội dung để thay đổi tham số của mô hình AI tạo sinh. Các mô hình chỉ dùng để phân loại hoặc xếp hạng không thuộc phạm vi
- Không thêm lệnh hay cú pháp mới; dùng nguyên cách viết robots.txt hiện có
- Ý nghĩa của các khai báo chỉ định tên crawler của từng công ty như GPTBot không thay đổi
Lưu ý, tài liệu này chưa phải là tiêu chuẩn chính thức của IETF mà mới ở giai đoạn đề xuất cá nhân.
Mức độ hỗ trợ của từng công ty
Cả 4 công ty đều tuyên bố sẽ hỗ trợ token chung, đồng thời cho biết các thiết lập riêng của từng công ty hiện có vẫn tiếp tục dùng được. Tuy nhiên, thời điểm và cách xử lý khác nhau tùy công ty.
- Anthropic: là công ty nộp tài liệu, và theo các báo cáo thì đã bắt đầu hỗ trợ
- OpenAI: sẽ hỗ trợ trong vài tháng tới. Công ty cho biết đây không phải là thứ thay thế các thiết lập hiện có
- Microsoft (Bing): từ ngày 1 tháng 2 năm 2027 sẽ áp dụng khai báo này khi thu thập dữ liệu (crawl)
- Google: đặt mục tiêu hỗ trợ trong năm 2027
Phần giải thích của Google có một điểm cần lưu ý. Nếu website từ chối huấn luyện bằng token chung mà không ghi gì về Google-Extended, Google dự định coi như Google-Extended cũng bị từ chối. Google-Extended không chỉ liên quan đến việc huấn luyện mô hình Gemini mà còn liên quan đến việc nội dung có được dùng làm căn cứ cho câu trả lời trong ứng dụng Gemini hay không. Google cho biết các website cho phép Google-Extended một cách rõ ràng sẽ tiếp tục được hiển thị làm căn cứ cho câu trả lời trong ứng dụng Gemini và vẫn có thể được nhấp vào.
Bing bổ sung cả thiết lập từ chối việc dùng làm "căn cứ câu trả lời"
Cùng ngày, Microsoft cũng công bố thiết lập tách biệt với huấn luyện, cho phép chọn có để trang được dùng làm căn cứ cho câu trả lời của AI (grounding) trên Bing, Copilot và các sản phẩm khác hay không.
- Huấn luyện: ngoài token chung trong robots.txt, còn có thể chỉ định theo từng trang bằng thẻ meta (ví dụ: <meta name="Bingbot" content="ai-training:disallow">) hoặc HTTP header. Khai báo theo từng trang được ưu tiên hơn khai báo trong robots.txt
- Căn cứ câu trả lời: theo từng trang, có thể chọn "disallow" để từ chối toàn bộ, hoặc "disallowextended" để chỉ từ chối việc sử dụng ngoài các sản phẩm của chính Microsoft
Microsoft cho biết các thiết lập này không làm thay đổi việc trang có đủ điều kiện xuất hiện trong kết quả tìm kiếm thông thường của Bing hay không. Mặt khác, công ty giải thích rằng nếu từ chối việc dùng làm căn cứ câu trả lời, trang sẽ khó xuất hiện hơn trong các câu trả lời do AI tạo ra. Ngoài ra, "NoArchive" và "NoCache", vốn được coi là cách thể hiện ý muốn liên quan đến AI, sẽ không còn được đọc cho mục đích đó kể từ ngày 1 tháng 3 năm 2027. Để chuyển tiếp, từ ngày 15 tháng 12 năm 2026, chỉ những website đang dùng NoArchive hoặc NoCache vào thời điểm đó mới có thể đặt thiết lập tạm thời về việc dùng làm căn cứ câu trả lời trong Bing Webmaster Tools.
Góc nhìn của ban biên tập CoAI
Trước đây, các website muốn từ chối huấn luyện AI phải bổ sung tên vào robots.txt mỗi khi xuất hiện crawler mới. Việc 4 công ty lớn cùng hỗ trợ một cách viết sẽ giảm đáng kể công sức đó. Việc các thiết lập cho phép tách bạch giữa huấn luyện AI tạo sinh và việc dùng làm căn cứ cho câu trả lời của AI ngày càng phổ biến cũng là một bước tiến đối với người vận hành website.
Tuy nhiên, mọi thứ sẽ không chuyển đổi ngay lập tức. Google và Microsoft chỉ bắt đầu hỗ trợ từ năm 2027, còn OpenAI cũng chỉ nói "trong vài tháng tới" mà không đưa ra ngày cụ thể. Hơn nữa, cơ chế này chỉ để truyền đạt ý muốn, không có sức ràng buộc đối với các công ty không hỗ trợ. Với Google, cần lưu ý rằng dù bạn chỉ định từ chối huấn luyện, nếu không cho phép Google-Extended thì nội dung sẽ không còn được dùng trong câu trả lời của ứng dụng Gemini. Trước mắt, giữ lại cả các khai báo riêng của từng công ty hiện có là cách an toàn.
Nguồn
- Machine-Readable Training Preference Signal (IETF Datatracker)
- Making it easier for websites to express AI training preferences (OpenAI)
- Supporting a shared AI training control for websites (Google Search Central Blog)
- Your content, your choice: clearer preferences for training and grounding (Microsoft Bing Blogs)
- Google, OpenAI, Microsoft, and Anthropic back a shared robots.txt AI training signal (Coywolf)
Các công cụ được nhắc đến trong bài viết
 ChatGPTAI hội thoại của OpenAI giúp trả lời câu hỏi, viết nội dung, tóm tắt, lập trình và phát triển ý tưởng.Xem chi tiết
 GeminiAI hội thoại của Google, có thể liên kết với Google Search và Workspace.Xem chi tiết
 ClaudeTrợ lý AI hội thoại của Anthropic, nổi bật với khả năng hiểu văn bản dài và tạo văn bản tự nhiên.Xem chi tiết
 Microsoft CopilotMicrosoft Copilot là dịch vụ thuộc lĩnh vực Trợ lý AI đa năng, có thể ứng dụng cho hỏi đáp và tìm kiếm.Xem chi tiết