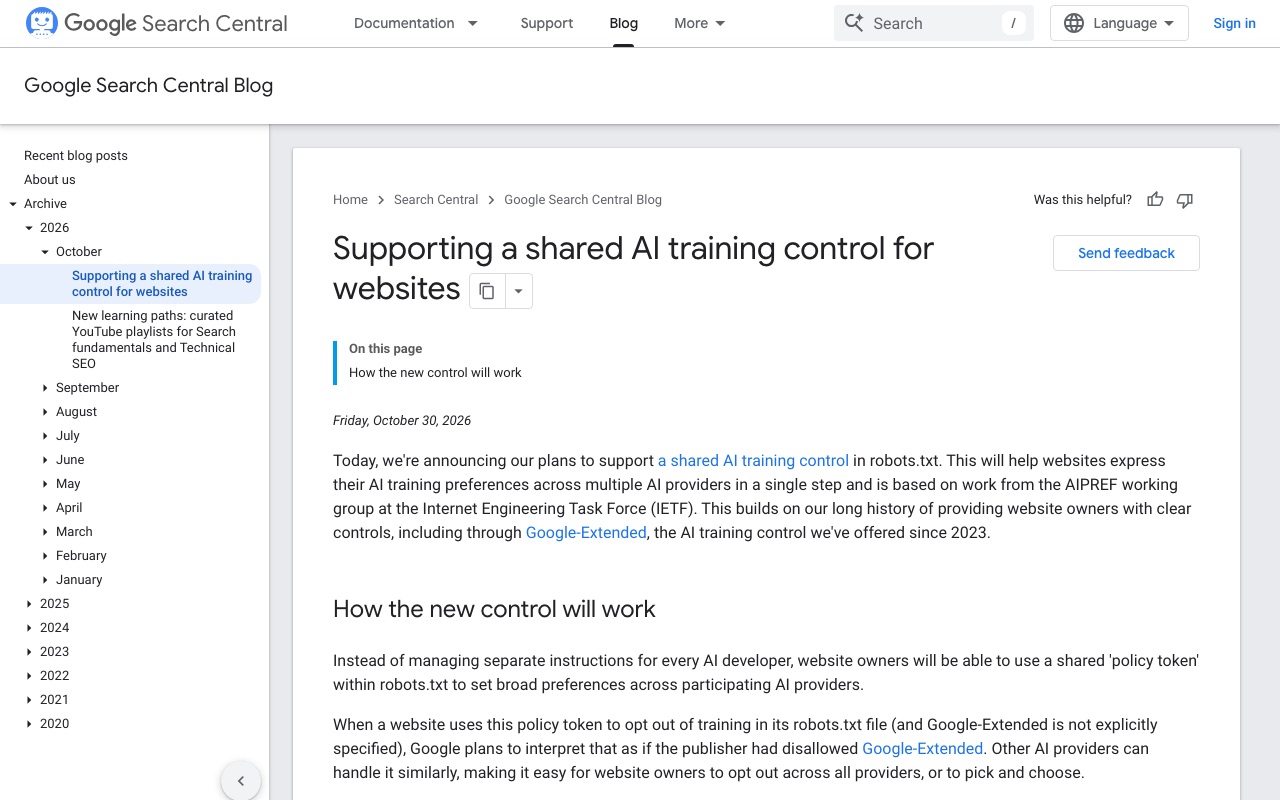
截圖顯示拍攝日期的官方頁面,可能與文章發布時不同。點選圖片可放大。
2026年10月30日(美國時間),OpenAI、Google、Microsoft與Anthropic四家公司宣布,將支援一項新機制:網站經營者可透過robots.txt的共通寫法,表明是否希望自家網站的內容被用於生成式AI的訓練。過去若要拒絕AI訓練,必須逐一寫上GPTBot、Google-Extended等各家公司的爬蟲名稱;今後只需一處寫法,就能一次向所有支援的公司表達意願。
機制:在robots.txt寫入「__usage_ai-training」
這項機制的基礎,是Anthropic的Kevin Kelley同一天向IETF(討論網際網路技術標準的組織)提交的文件「Machine-Readable Training Preference Signal」。在robots.txt中通常填寫爬蟲名稱的「User-Agent」一行寫入共通 token「__usage_ai-training」,再以其下方的Disallow(拒絕)與Allow(允許),依路徑表明內容是否可用於訓練。
文件中的範例如下。
- User-Agent: __usage_ai-training
- Disallow: /
- Allow: /press-kit/
在這個例子中,網站表明不希望整個網站的內容被用於訓練,只有/press-kit/以下的內容可用於訓練。
文件也規定了以下幾點。
- 「User-Agent: *」(針對所有爬蟲的指定)不適用於這個 token。若要拒絕訓練,必須明確寫出這個 token
- 這裡所說的訓練,是指用於改變生成式AI模型的參數。僅用於分類或排序的模型不在範圍內
- 不新增指令或語法,直接沿用既有的robots.txt寫法
- 指定GPTBot等各家爬蟲名稱的寫法,其意義維持不變
需要注意的是,這份文件並非IETF的正式標準,目前仍處於以個人提案形式提出的階段。
各家公司的支援情況
四家公司都表示,既有的各公司專屬設定今後仍可繼續使用,同時將支援這個共通 token。不過,支援的時間與處理方式因公司而異。
- Anthropic:提交該文件的公司,據報導已開始支援
- OpenAI:將在未來幾個月內支援,並表示這不會取代現有設定
- Microsoft(Bing):自2027年2月1日起,在爬取時反映這項指定
- Google:目標在2027年支援
Google的說明中有一點需要注意。如果網站以共通 token拒絕訓練,卻對Google-Extended未作任何說明,Google預計會將Google-Extended也視為遭到拒絕。Google-Extended除了涉及Gemini模型的訓練,也關係到內容是否會在Gemini應用程式中被用作回答的依據。Google表示,明確允許Google-Extended的網站,將持續作為Gemini應用程式回答的依據顯示,並可被點擊。
Bing也新增拒絕用作「回答依據」的設定
同一天,Microsoft也發表了一項與訓練分開的設定,讓網站可選擇頁面是否被用作Bing、Copilot等AI回答的依據(grounding)。
- 訓練:除了robots.txt的共通 token,也可依頁面透過meta標籤(例:<meta name="Bingbot" content="ai-training:disallow">)或HTTP標頭指定。依頁面的指定優先於robots.txt的指定
- 回答依據:可依頁面選擇全部拒絕的「disallow」,或只拒絕Microsoft自家產品以外用途的「disallowextended」
Microsoft表示,這些設定不會改變網頁是否能出現在Bing一般搜尋結果中。但它也說明,若拒絕用作回答依據,頁面在AI產生的回答中出現的機會將會降低。此外,過去被視為AI相關意願表達的「NoArchive」與「NoCache」,自2027年3月1日起將不再依此用途讀取。為了過渡,自2026年12月15日起,僅限屆時正在使用NoArchive或NoCache的網站,可在Bing Webmaster Tools進行有關回答依據的暫時設定。
CoAI編輯部觀點
過去想拒絕AI訓練的網站,每當出現新的爬蟲,就得在robots.txt補寫名稱。四家主要公司支援同一種寫法,將大幅減少這方面的工夫。能把生成式AI的訓練與用作AI回答依據分開考量的設定逐漸普及,對網站經營者來說也是一大進步。
不過,一切並不會馬上切換。Google與Microsoft要到2027年才開始支援,OpenAI也只表示「未來幾個月內」,並未提出具體日期。而且,這項機制終究只是傳達意願,對未支援的公司並沒有強制力。以Google來說,要留意的是:即使本意只是拒絕訓練,若沒有允許Google-Extended,內容也將不再被用於Gemini應用程式的回答。目前較穩妥的做法,是同時保留既有的各公司專屬寫法。
資料來源
- Machine-Readable Training Preference Signal(IETF Datatracker)
- Making it easier for websites to express AI training preferences(OpenAI)
- Supporting a shared AI training control for websites(Google Search Central部落格)
- Your content, your choice: clearer preferences for training and grounding(Microsoft Bing部落格)
- Google, OpenAI, Microsoft, and Anthropic back a shared robots.txt AI training signal(Coywolf)